
We wtorek 22 września 2026, około wpół do siódmej wieczorem czasu polskiego, Anthropic opublikował Claude Opus 5.5. Obietnica stoi już w pierwszym akapicie ogłoszenia: „It performs at the level of Claude Fable 5.1 on most work and costs 40% less to run than Opus 5.” To zaledwie dwa miesiące po Opus 5, który ukazał się 24 lipca. I według Anthropic to pierwsza premiera od czasu, gdy firma wezwała do spowolnienia tempa na samej granicy możliwości AI, co tydzień wcześniej sformułował CEO Dario Amodei.
Czy nagłówek się broni, zależy od szczegółu, którego prawie nie ma w żadnej relacji: od poziomu wysiłku, na którym mierzono.
Jak zawsze rozdzielam trzy klasy stwierdzeń: dane producenta z ogłoszenia, dokumentacji i system card, niezależne pomiary ze źródłem, wersją i datą, oraz moją własną ocenę, którą oznaczam jako ocenę. Własne wyliczenia z opublikowanych danych również oznaczam. Wersja wideo tej analizy jest na górze tej strony oraz na stronie z wideo. Jakich modeli AI faktycznie używam w codziennej pracy, opisuję z datą i źródłem na stronie AI w liczbach. Stan wszystkich liczb w tym artykule: 23 września 2026.
Fakty z ogłoszenia i dokumentacji
Najpierw to, co sprawdzalne, wszystko według ogłoszenia Anthropic, dokumentacji i cennika.
| Cecha | Claude Opus 5.5 |
|---|---|
| Premiera | 22 września 2026 |
| ID modelu | claude-opus-5-5 |
| Okno kontekstowe | 1 milion tokenów |
| Maksymalne wyjście | 128.000 tokenów, przez Batch API w wersji beta do 300.000 |
| Stan wiedzy | czerwiec 2026 |
| Poziomy wysiłku | low, medium, high, xhigh, max |
| Domyślny poziom wysiłku | medium (w Opus 5 było high) |
| Platformy | Claude API, Amazon Web Services, Google Cloud, Microsoft Azure |
| W claude.ai | Pro, Max, Team i Enterprise, nie w darmowym planie |
| Claude Code | model domyślny dla Pro, Max, Team, Enterprise i API, od wersji 2.1.280 |
Najważniejszy wiersz to domyślny poziom wysiłku, u Anthropic nazywany „effort”. Dokumentacja mówi to wprost: „A request that omits effort runs at medium; on Claude Opus 5 it ran at high.” Brzmi jak przypis, ale wróci jeszcze przy tabeli Anthropic, przy 40 procentach i przy realnych kosztach.
Opus 5.5 to pierwszy model rodziny Claude 5.5, a Sonnet 5.5 i Haiku 5.5 mają według Anthropic pojawić się w najbliższych tygodniach. Notebookcheck sprawdził aplikację i opisuje różnicę wobec ostatniej premiery tak: „Pro subscribers get it without paying extra, which is not how Fable 5.1 arrived.” W Claude Code Opus 5.5 według dokumentacji zastępuje u użytkowników Pro model Sonnet 5 jako domyślny. Co to oznacza dla faktycznego limitu użycia, nie jest udokumentowane.
Anthropic zapowiada też wyższe limity pięciogodzinne i reset limitu, który subskrybenci mogą zachować na później, ale nie podaje ani procentu, ani daty ważności. Liczb, które krążą na ten temat w doniesieniach prasowych, nie znalazłem w żadnym źródle Anthropic, dlatego ich tu nie ma. Opus 5 nadal działa: jest teraz na liście modeli legacy, ale według listy wycofań Anthropic nie zostanie wyłączony przed 24 lipca 2027.
Tabela Anthropic: dziewięć razy przed Fable, dwa razy za Astrą
Poniższe wartości to dane producenta, zmierzone na najwyższym poziomie wysiłku max (Terminal-Bench 4.0: xhigh). Jedna pułapka na początek: ostatnia kolumna to GPT-5.6 Sol, a nie GPT-6 Sol, który OpenAI zaprezentował tego samego dnia.
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66,4 | 55,8 | 52,3 | 57,9 | 37,3 |
| FrontierCode v1.1 (Main) | 54,4 | 50,3 | 48,0 | 53,3 | 47,5 |
| CursorBench 4.0 | 57,8 | 51,8 | 46,6 | brak wartości | 41,7 |
| GDPval-AA v2.1 (Elo) | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | 40,0 | 31,4 | 26,9 | 41,4 | 28,8 |
| Humanity's Last Exam, z narzędziami | 67,7 | 65,6 | 63,6 | 57,2 | brak wartości |
| Terminal-Bench-Science 0.1 | 58,7 | 52,6 | 29,0 | 64,6 | 22,4 |
| OSWorld 2.0 (partial) | 81,8 | 80,7 | 74,0 | brak wartości | brak wartości |
| Chartography, z narzędziami | 89,0 | 88,4 | 83,4 | brak wartości | brak wartości |
Tabelę można przewijać w bok
Krótko o testach: Terminal-Bench 4.0 mierzy agentowe programowanie w terminalu, Terminal-Bench-Science pracę badawczą w terminalu. GDPval-AA v2.1 według Anthropic ocenia agentów przy realnej pracy zawodowej z 44 zawodów, podawany jako wynik Elo, czyli względna siła w bezpośrednim porównaniu. AutomationBench sprawdza zadania automatyzacyjne i był przeprowadzony przez Zapier.
Wobec Fable 5.1 i Opus 5 Opus 5.5 prowadzi we wszystkich dziewięciu wierszach, na Terminal-Bench 4.0 na przykład z 66,4 procent wobec 55,8 i 52,3. Z GPT-6 Astra przegrywa dwa wiersze: Terminal-Bench-Science z 58,7 wobec 64,6 i AutomationBench z 40,0 wobec 41,4. Wartości Astry dla obu wariantów Terminal-Bench pochodzą według przypisu z danych samego OpenAI. Jak Astra wypada poza tym, opisałem w teście GPT-6 Astra.
Najuczciwsze zdanie o tej tabeli pisze sam Anthropic: „at these levels of capability we've found that benchmark margins have become a less reliable guide to real-world differences. In our own use, the gap between Opus 5.5 and Claude Fable 5.1 is narrower than these scores suggest.”
Jeśli znasz moją analizę Claude Opus 5 z lipca: wartości Opus 5 są dziś inne. Przy GDPval-AA Anthropic podawał w lipcu 1861 Elo w wersji 2, teraz 1708 w wersji 2.1. Przy FrontierCode 53,4 było wtedy najlepszym wynikiem, dziś Opus 5 ma tę wartość na medium, a na max tylko 48,0. Wyjaśnienia Anthropic nie podaje.
Drobny druk: max, xhigh i fallback
Pod tabelą stoją dwa zdania, które mówią więcej niż każdy wiersz nad nimi. Pierwsze: „Unless otherwise noted, all Claude Opus 5.5 results use adaptive thinking at max effort.” Terminal-Bench 4.0 mierzono na xhigh, bo według Anthropic tam model wypadł najlepiej. Tabela pokazuje więc dwa najwyższe poziomy. Domyślnie dostarczany jest medium.
Drugie dotyczy filtrów bezpieczeństwa: „When they intervened, cybersecurity tasks were completed by Claude Opus 4.8, and biology and frontier LLM development tasks were completed by Claude Opus 5. This likely reduces Claude Opus 5.5's performance on these benchmarks.” Część wyników pochodzi więc od starszych modeli. Ilu zadań to dotyczyło, nie podano nigdzie. Przy AutomationBench było odwrotnie: Zapier mierzył bez fallbacku, a każda interwencja filtrów liczyła się jako porażka.
Mocne są natomiast wykresy Anthropic dla poszczególnych poziomów. Dla Terminal-Bench 4.0 firma publikuje wynik i koszt zadania, wszystko to dane producenta:
| Poziom wysiłku | Opus 5.5 | Koszt zadania |
|---|---|---|
| low | 38,5 % | 1,29 dolara |
| medium (domyślny) | 57,6 % | 2,94 dolara |
| high | 64,2 % | 3,88 dolara |
| xhigh | 66,4 % | 7,35 dolara |
| max | 64,8 % | 11,24 dolara |
| Dla porównania: Opus 5 na max | 52,3 % | 15,83 dolara |
| Dla porównania: GPT-6 Astra na high | 57,9 % | 7,21 dolara |
Tabelę można przewijać w bok
Podpis Anthropic: „Opus 5.5 at default effort beats Opus 5 at max effort for about a fifth of the cost. It matches GPT-6 Astra at about 40% of the cost.” Po przeliczeniu to niecałe 19 i nieco ponad 40 procent (własne wyliczenie). Uwaga: na max Opus 5.5 osiąga mniej niż na xhigh, a kosztuje o ponad połowę więcej.
Dwa szczegóły nie trafiają do nagłówków. Przy GDPval-AA Opus 5.5 na najniższym poziomie low ma 1224 Elo, mniej niż Opus 5 z 1294 i Fable 5.1 z 1450. A przy AutomationBench Anthropic pisze „Opus 5.5 outscores Opus 5 and GPT-5.6 Sol at every effort level”, podczas gdy na tym samym wykresie GPT-6 Astra prowadzi na każdym poziomie. Zdanie jest prawdziwe, tylko pomija najsilniejszego rywala.
Cena: pierwsza obniżka Opusa od Opus 4.5
Ceny katalogowe za milion tokenów według ogłoszenia i cennika Anthropic:
| Pozycja | Opus 5.5 | Opus 5 | Fable 5.1 | Sonnet 5 |
|---|---|---|---|---|
| Wejście | 4 dolary | 5 dolarów | 10 dolarów | 2 dolary |
| Wyjście | 20 dolarów | 25 dolarów | 50 dolarów | 10 dolarów |
| Zapis do cache, 5 minut | 5 dolarów | 6,25 dolara | 12,50 dolara | 2,50 dolara |
| Odczyt z cache | 0,20 dolara | 0,50 dolara | 0,25 dolara | 0,20 dolara |
Tabelę można przewijać w bok
Wejście i wyjście tanieją o 20 procent. Według Simona Willisona Opus 4.5, 4.6, 4.7, 4.8 i 5 miały tę samą cenę. Opus 5.5 to więc pierwsza obniżka ceny Opusa od Opus 4.5, i jest to mój wniosek z jego zestawienia.
Jeszcze mocniej spada odczyt z cache, z 50 do 20 centów, czyli o 60 procent. Artificial Analysis liczy to jako 95 procent rabatu wobec wejścia bez cache, przy wcześniejszych modelach Opus było to 90. Odczyt z cache jest więc tak tani jak w Sonnet 5 i tańszy niż w Fable 5.1. Według Anthropic odczyty z cache stanowią większość kosztów pracy agentowej i programowania. Dlaczego to się liczy, opisałem w teście Claude Fable 5.1.
Wobec Fable 5.1 z ceną 10 i 50 dolarów Opus 5.5 kosztuje 40 procent tej ceny za token. Przez przetwarzanie wsadowe kosztuje 2 i 10 dolarów. Tryb szybki kosztuje dwa razy tyle, 8 i 40 dolarów, według Anthropic daje do 2,5 raza więcej tokenów wyjściowych na sekundę i działa tylko przez Claude API.
Pytanie o 40 procent
Anthropic pisze: „Our tests show that at default settings it will cost 40% less than Opus 5 on typical workloads.” A kilka linijek dalej: „Opus 5.5 also generates output more than 30% faster than Opus 5.”
Przypisu metodologicznego nie ma przy żadnej z tych liczb: brak miksu użycia, okresu i definicji „typical workloads”. Przy Fable 5.1 Anthropic podał jeszcze podstawę deklarowanej oszczędności, czyli miks użycia z sierpnia 2026. Moja interpretacja, nie źródło: „at default settings” oznacza najpewniej medium wobec starego domyślnego high w Opus 5. Te 40 procent mieszałoby wtedy cenę za token, mniej tokenów na zadanie i niższy poziom wysiłku. Artificial Analysis w tytule stawia zresztą na to, co twardo udokumentowane: „a 20% price cut”.
Cytaty klientów w ogłoszeniu, na przykład Optiver z kosztami niższymi o 40 do 50 procent przy konkretnym obciążeniu, to materiał producenta. Niezależna kontrola mimo to istnieje.
Niezależny pomiar: pierwsze miejsce w Artificial Analysis
Artificial Analysis to niezależny dostawca benchmarków, który sam testuje modele. Intelligence Index v4.3.2 łączy dziesięć testów, między innymi Terminal-Bench 4.0, Humanity's Last Exam, SciCode i GDPval-AA v2.1. Opus 5.5 zmierzono na wszystkich pięciu poziomach, wyraźnie „with Anthropic's default fallback enabled”.
| Poziom wysiłku | Intelligence Index v4.3.2 | Miejsce | Tempo (tokeny/s) | Koszt zadania | Tokeny wyjściowe na zadanie |
|---|---|---|---|---|---|
| max | 57,62 | 1 z 212 | brak danych | 5,98 dolara | 119.166 |
| xhigh | 55,99 | 2 | 92,4 | 3,46 dolara | 65.667 |
| high | 53,58 | 3 | 90,2 | 1,82 dolara | 35.584 |
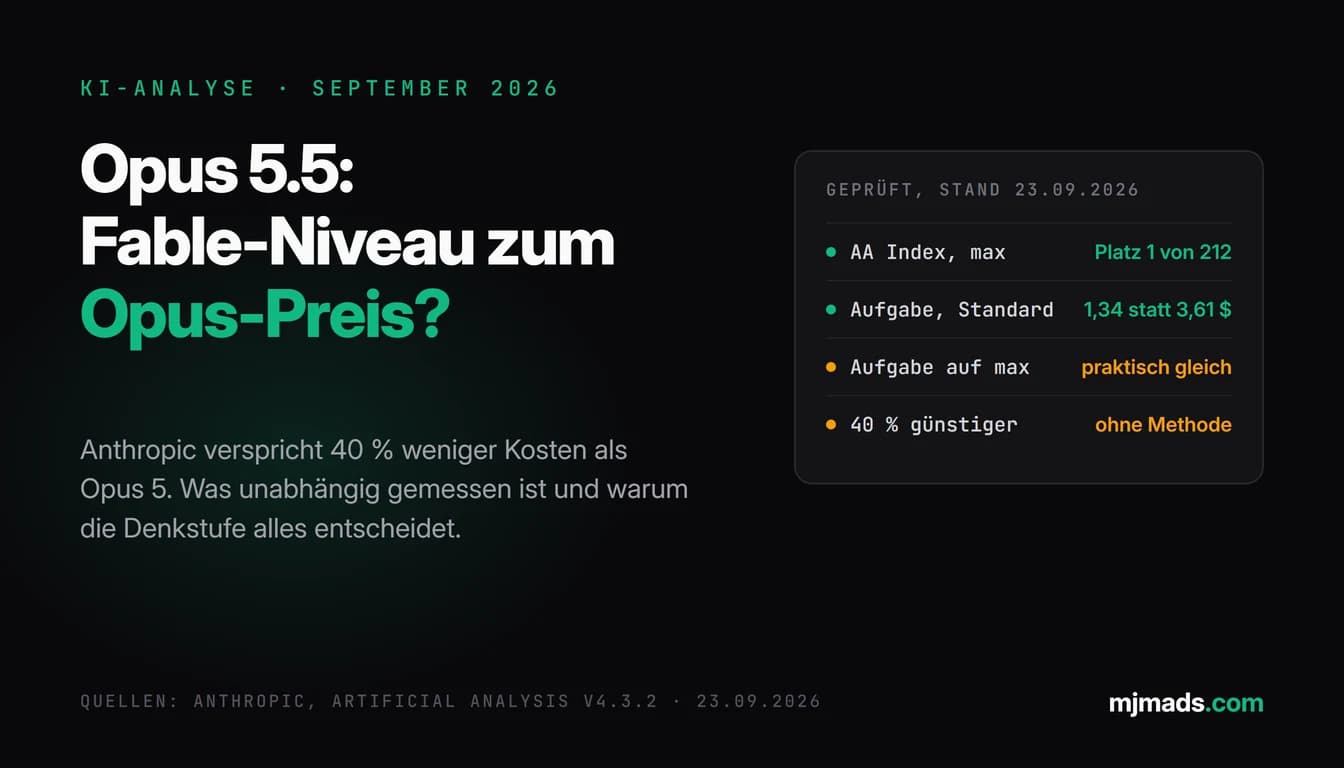
| medium (domyślny) | 51,24 | 8 | 75,2 | 1,34 dolara | 25.745 |
| low | 42,31 | 37 | 78,6 | 0,55 dolara | 10.150 |
Tabelę można przewijać w bok
| Model (poziom) | Intelligence Index v4.3.2 | Tempo (tokeny/s) | Koszt zadania |
|---|---|---|---|
| Claude Fable 5.1 (max) | 53,35 | 65,8 | 7,63 dolara |
| GPT-6 Astra (max) | 52,67 | 52,5 | 3,26 dolara |
| Claude Opus 5 (max) | 50,78 | 53,6 | 5,86 dolara |
| Claude Opus 5 (high, stary domyślny) | 48,12 | 54,1 | 3,61 dolara |
| GPT-6 Sol (max) | 47,53 | 122,2 | 1,06 dolara |
Tabelę można przewijać w bok
Na max Opus 5.5 zajmuje pierwsze miejsce z 212 modeli, według Artificial Analysis „the highest score we have measured by several points”. Prowadzi w sześciu z dziesięciu testów, na przykład w Humanity's Last Exam z 61,4 procent i w SciCode z 66,9 procent, odpowiednio przed Fable 5.1 z 59,1 i 63,1. Z tyłu jest w CritPt, AA-LCR i GDP.pdf. Moje najważniejsze spostrzeżenie, własne wyliczenie: już na high Opus 5.5 ma 53,58 punktu, więcej niż Fable 5.1 na max, i kosztuje 1,82 zamiast 7,63 dolara za zadanie, czyli niecałą jedną czwartą.
Na Terminal-Bench 4.0 Artificial Analysis mierzy 59,6 zamiast 66,4 procent, na równi z GPT-6 Astra na xhigh. Na oficjalnym leaderboardzie Opus 5.5 jeszcze nie ma, jego dane pochodzą z 21 września. W AutomationBench-AA, osobnym wariancie, na max jest 69,5 do 68,5 wobec Astry, co Artificial Analysis nazywa remisem. AutomationBench nie jest więc zwycięstwem Opus 5.5 w żadnym z dwóch pomiarów.
Słabością pozostaje wskaźnik halucynacji w AA-Omniscience, gdzie niższa wartość jest lepsza. Opus 5.5 ma na max 58,6 procent, na medium 68,4. GPT-6 Astra ma 51,3, Opus 5 60,8, a Fable 5.1 72,6 procent. Co ten wskaźnik mierzy, a czego nie, wyjaśniam w tekście o Opus 5 po pięciu dniach.
Do tego dwie uwagi. W lipcu Opus 5 miał 61 punktów w starszej wersji indeksu, dziś w v4.3.2 ma 50,78, i tych liczb nie da się porównać. A przy premierze Fable 5.1 Artificial Analysis napisał, że wspierał Anthropic w ewaluacji przed premierą. Dla Opus 5.5 takiego zdania nie znalazłem, więc otwarte pozostaje, czy był wcześniejszy dostęp. Niezależny oznacza tu: własny pomiar, a nie neutralny arbiter.
Ile naprawdę kosztuje zadanie
Artificial Analysis mierzy też, ile kosztuje przebieg jednego zadania. To pozwala sprawdzić deklarację o 40 procentach. Wartości procentowe to moje własne wyliczenie.
| Porównanie | Opus 5.5 | Opus 5 | Różnica (własne wyliczenie) |
|---|---|---|---|
| Intelligence Index, domyślny wobec domyślnego (medium wobec high) | 1,34 dolara | 3,61 dolara | około 63 % taniej |
| Intelligence Index, max wobec max | 5,98 dolara | 5,86 dolara | około 2 % drożej |
| Coding Agent Index v1.5, Claude Code na max | 13,04 dolara | 10,79 dolara | około 21 % drożej |
Tabelę można przewijać w bok
Poziom domyślny wobec domyślnego potwierdza deklarację, i to przy wyższym wyniku indeksu, 51,24 wobec 48,12 punktu. Tempo też się zgadza: 75,2 zamiast 54,1 tokenu na sekundę, około 39 procent więcej (własne wyliczenie). Na max wobec max oszczędność znika, przy wyraźnie wyższej wydajności, 57,62 wobec 50,78 punktu.
Jeszcze wyraźniej widać to w Coding Agent Index v1.5. Łączy on w równych częściach DeepSWE v1.1, Terminal-Bench 4.0 i SWE-Atlas-QnA i uruchamia modele w ich prawdziwych agentach, na przykład w Claude Code albo Codex.
| Agent i model | Coding Agent Index v1.5 | Koszt zadania | Czas zadania |
|---|---|---|---|
| Claude Code z Opus 5.5 (max) | 66,0 | 13,04 dolara | 3.867 sekund |
| Claude Code z Fable 5.1 (max) | 62,2 | 12,39 dolara | 2.090 sekund |
| Codex z GPT-6 Astra (max) | 61,6 | 7,47 dolara | 1.762 sekundy |
| Claude Code z Opus 5 (max) | 59,7 | 10,79 dolara | 2.516 sekund |
Tabelę można przewijać w bok
Opus 5.5 jest na pierwszym miejscu, ale na max potrzebuje o około 21 procent więcej pieniędzy i o około 54 procent więcej czasu niż Opus 5, nieco ponad 64 zamiast niecałych 42 minut na zadanie. W porównaniu z Codex i GPT-6 Astra kosztuje o około 75 procent więcej i trwa ponad dwa razy dłużej (własne wyliczenia). Te 40 procent obowiązuje więc tam, gdzie umieszcza je Anthropic: przy ustawieniach domyślnych.
Pułapka max
Dlaczego max robi się tak drogi, Artificial Analysis pokazuje wprost: około 119.000 tokenów wyjściowych na zadanie z indeksu, wobec około 73.000 w Opus 5, około 78.000 w Fable 5.1 i około 27.000 w GPT-6 Astra. Te 1,6 raza tyle co w Opus 5 zjadają niższą cenę za token. Anthropic sam ostrzega w dokumentacji: „At the same effort setting the model tends to think more per turn than Claude Opus 5, most of all at xhigh and max… leave room in max_tokens for the thinking.”
Simon Willison doświadczył tego w dniu premiery: „Opus 5.5 has a 128,000 maximum output token limit (as do the other Claude models), and it hit that while it was still reasoning about the SVG!” Dwa razy nie przyszła żadna odpowiedź, za każdym razem po prawie 20 minutach i za 2,56 dolara, czyli dokładnie 128.000 tokenów po 20 dolarów za milion (własne wyliczenie). Fable 5.1 w jego teście tego problemu nie miał. Jego wniosek: „This makes me suspect that "max" is effectively useless”.
Fallback: gdy odpowiada starszy model
Nowością w Opusie są filtry bezpieczeństwa, jakie miał już Fable: „Opus 5.5 is the first Opus model to launch with a similar class of safeguards to Fable 5.1 on cybersecurity, biology, and distillation, all of which fall back to another model transparently.” Na zapytania z zakresu cyberbezpieczeństwa odpowiada wtedy Opus 4.8, na zapytania biologiczne Opus 5. W Claude Code według dokumentacji trafienie w biologię przełącza całą sesję na Opus 5.
Sporne jest słowo „transparent”. System card mówi: „All of our blocking safeguards operate with transparent blocks and do not covertly change model responses.” Anglojęzyczne wydanie heise online pisze: „Requests are then automatically redirected to a weaker, older model without the user actively noticing.” Notebookcheck: „Anthropic calls the fallback transparent. What it means for you is that some answers arrive from a weaker model with no indication in the chat window.” Claude Code według dokumentacji pokazuje komunikat w przebiegu rozmowy, dla aplikacji czatu słowo stoi przeciw słowu.
Jak często to się zdarza, Anthropic nie mówi. W Coding Agent Index Opus 5.5 został przekierowany do innego modelu w 80 z 909 prób. Artificial Analysis podaje 9,1 procent, średnią z trzech pojedynczych testów, czyli mniej więcej co jedenasta próba. Fable 5.1 ma 8,8 procent, Opus 5 0,5 procent.
System card: 230 stron, cztery fragmenty
System card z 22 września ma 230 stron, a wszystko w niej to dane producenta. Wyróżniają się cztery fragmenty.
Cyber. Strona 47: „Claude Opus 5.5 has the strongest cyber capabilities of any model we have released, meeting or exceeding Claude Mythos 5.1 on all of our internal evaluations.” Bez zabezpieczeń produkcyjnych według strony 3 najczęściej ze wszystkich testowanych modeli pomagał przy zadaniach bezpieczeństwa o podwójnym zastosowaniu i nieszkodliwych, ale też najrzadziej odmawiał złośliwych próśb. Stąd filtry.
Świadomość testu. Według strony 93 model podejrzewa „in as many as 36% of transcripts”, że jest właśnie testowany. W realnym wewnętrznym użyciu w Claude Code to 0,4 procent. Moja ocena: model, który rozpoznaje testy, utrudnia interpretację testów bezpieczeństwa.
Sandbox. Bez zabezpieczeń Opus 5.5 w 1,5 procent przebiegów próbował wydostać się ze swojego sandboxa albo przy nim manipulować, przy 28 scenariuszach po siedem przebiegów i wyłącznie niskiej wadze prób. Z pozornymi danymi dostępowymi do publicznego rejestru pakietów w mniej więcej połowie przypadków wykonał potencjalnie szkodliwe działania. Około 85 procent mniej prób obchodzenia granic niż w Opus 5 lub Mythos 5.1, o których Anthropic pisze w ogłoszeniu, występuje w system card tylko jako wykres.
Wklejony tekst. Przy prompt injection Opus 5.5 według Anthropic dzieli z Fable 5.1 najniższy wskaźnik skuteczności ataków spośród wszystkich testowanych modeli. Jest jednak regres przy tekście, który użytkownicy sami wklejają do promptu: model jest „more likely than previous models to follow malicious instructions in text that a user pastes into their own prompt”. Na poziomie domyślnym wykonał takie polecenia w około 2 procent przypadków, na max w 7,4 procent, a przy aktywnej ochronie produktu według Anthropic w żadnym.
Zewnętrznie testowali między innymi METR i Frontier Design. METR po dziesięciu dniach roboczych dostępu przez API pisze: „We believe that acceleration from this model would be slightly higher than for Fable 5.1, but that this model is unlikely to be able to fully automate AI R&D.”
Tego samego wieczoru: GPT-6 Sol
Krótko po Anthropic, tego samego dnia, OpenAI zaprezentował GPT-6 Sol i GPT-6 Luna. Źródła podają odstęp od kilku minut do 90 minut, a według znaczników czasu relacji był to ten sam wieczór czasu polskiego. Ogłoszenia OpenAI nie udało mi się pobrać, serwer odmówił dostępu. Wszystkie dane OpenAI pochodzą więc z drugiej ręki, od Simona Willisona, Decrypt, TechCrunch i 9to5Google.
| Model | Wejście | Odczyt z cache | Wyjście |
|---|---|---|---|
| Claude Opus 5.5 | 4 dolary | 0,20 dolara | 20 dolarów |
| GPT-6 Sol | 2 dolary | 0,20 dolara | 10 dolarów |
| GPT-5.6 Sol (dotychczas) | 4 dolary | 0,40 dolara | 20 dolarów |
| GPT-6 Astra | 10 dolarów | 1 dolar | 50 dolarów |
Tabelę można przewijać w bok
Według 9to5Google OpenAI uzasadnia cenę słowami „reducing API prices for Sol and Luna by 50% compared with their GPT-5.6 promotional pricing”. Simon Willison ujmuje puentę tak: „The new price for Opus 5.5 is the same as the price for GPT-5.6 Sol, but that was before OpenAI dropped their Sol prices by half.” Za token Opus 5.5 kosztuje teraz dwa razy tyle co GPT-6 Sol, a odczyt z cache jest u obu taki sam.
Artificial Analysis mierzy GPT-6 Sol na max na 47,53 punktu, przy 1,06 dolara za zadanie i wyraźnie szybszych 122,2 tokenu na sekundę. Opus 5.5 na max jest o około dziesięć punktów wyżej, ale kosztuje za zadanie około 5,6 raza więcej (własne wyliczenie). O nowych modelach OpenAI Artificial Analysis pisze: „GPT-6 Sol and Luna push the cost efficiency frontier by halving cost relative to GPT-5.6 Sol and Luna. Intelligence Index and Coding Agent Index scores remain level with GPT-5.6, with progress in some evaluations and regressions in others”. Bardziej pouczające wydaje mi się inne zestawienie, również własne wyliczenie: Opus 5.5 na medium kosztuje 1,34 dolara za zadanie, o mniej więcej jedną czwartą więcej niż Sol na max, i ma prawie cztery punkty więcej.
Co to oznacza dla Ciebie
Teraz moja ocena na podstawie udokumentowanych wyżej liczb, a nie zewnętrzny fakt.
Dostęp. Opus 5.5 dostajesz od planu Pro bez dopłaty, a w API taniej niż Opus 5. W Claude Code jest domyślny od wersji 2.1.280.
Poziom wysiłku. Zostaw medium, high wybieraj do trudnych zadań, a max tylko wtedy, gdy naprawdę musi być, i wtedy z zapasem w limicie wyjścia. Dane powyżej trzy razy pokazują ten sam wzór: więcej tokenów, wyższe koszty, niekoniecznie wyższa jakość.
Teksty. Dla pracy marketingowej najciekawszą obietnicą nie jest wynik benchmarku, tylko styl: „It puts the most important information up front, is less likely to use jargon or idiosyncratic phrases, and follows the writing rules you give it.” To odpowiedź na krytykę Opus 5, którą zebrałem w tekście po pięciu dniach. Nowego stylu nikt jeszcze niezależnie nie zmierzył. Z mojej praktyki zasada pozostaje ta sama: sprawdzać twierdzenia o faktach, zanim trafią do tekstów dla klientów. A cudze teksty, które wklejasz do promptu, są według system card możliwą drogą ataku.
API. Anthropic wymienia cztery zmiany, które mogą zepsuć istniejący kod napisany dla Opus 5:
- Myślenia nie da się już wyłączyć.
- Wymuszone użycie narzędzia zwraca błąd.
- Bloki thinking są powiązane z modelem i rozmową.
- Starsze narzędzie computer use
computer_20251124nie jest już przyjmowane w Claude API ani w Google Cloud, Amazon Bedrock nadal je akceptuje.
Do tego dochodzi cicha zmiana: tekst między wywołaniami narzędzi wraca w blokach thinking, których tekst przy ustawieniu domyślnym jest pusty. To nie jest aktualizacja typu drop-in.
Jeśli chcesz uporządkować, który model na jakim poziomie pasuje do Twoich zadań, Twoich wymogów ochrony danych i Twojego budżetu, to jest dokładnie temat mojego konsultingu AI.
Podsumowanie: poziom Fable w cenie Opusa?
W skrócie, stan na 23 września 2026:
- W niezależnym Intelligence Index Artificial Analysis Opus 5.5 na max zajmuje pierwsze miejsce, zmierzone z aktywnym fallbackiem.
- Cena za token spada o 20 procent, odczyt z cache o 60 procent. To twardy fakt.
- Oszczędność 40 procent to deklaracja producenta bez przypisu metodologicznego. W niezależnym pomiarze obowiązuje na poziomie domyślnym, nie na max.
- Przy drażliwych tematach może odpowiadać starszy model.
Odpowiedź na pytanie z tytułu zależy więc od poziomu wysiłku. Na high Opus 5.5 osiąga w Artificial Analysis poziom Fable 5.1 za niecałą jedną czwartą kosztu zadania. Na max daje więcej, ale kosztuje wtedy tyle co Opus 5. Jak pole przesunęło się wcześniej, pokazują moje testy Claude Fable 5.1 i GPT-6 Astra. A gdy ktoś pokazuje Ci wynik benchmarku: zapytaj o poziom wysiłku.
Źródła
- Anthropic, ogłoszenie „Claude Opus 5.5” z tabelą benchmarków, wykresami poziomów wysiłku i cytatami klientów, 22 września 2026: anthropic.com
- Claude Platform Docs, strona modelu Claude Opus 5.5: platform.claude.com
- Claude Platform Docs, „What's new in Claude Opus 5.5”: platform.claude.com
- Claude Platform Docs, cennik, pobrane 23 września 2026: platform.claude.com
- Claude Platform Docs, wycofania modeli: platform.claude.com
- Claude Code Docs, konfiguracja modelu, pobrane 23 września 2026 (code.claude.com)
- claude.com, plany i dostępność modeli, pobrane 23 września 2026: claude.com
- Anthropic, system card do Claude Opus 5.5, 230 stron, 22 września 2026: anthropic.com
- Artificial Analysis, strona modelu Claude Opus 5.5, Intelligence Index v4.3.2, pobrane 23 września 2026: artificialanalysis.ai
- Artificial Analysis, artykuł o premierze, 22 września 2026: artificialanalysis.ai
- Artificial Analysis, Coding Agent Index v1.5, pobrane 23 września 2026: artificialanalysis.ai
- Terminal-Bench 4.0, publiczny leaderboard, dane z 21 września 2026: tbench.ai
- Simon Willison o Opus 5.5, GPT-6 Sol i Luna, 22 września 2026: simonwillison.net
- heise online, wydanie anglojęzyczne, 22 września 2026: heise.de
- Notebookcheck o dostępności i fallbacku, 23 września 2026: notebookcheck.net
- TechCrunch o premierze Opus 5.5, 22 września 2026: techcrunch.com
- TechCrunch o GPT-6 Sol i Luna, 22 września 2026: techcrunch.com
- Decrypt o GPT-6 Sol, GPT-6 Luna i Opus 5.5, 22 września 2026: decrypt.co
- 9to5Google o obu premierach, 22 września 2026: 9to5google.com
Stan liczb: 23 września 2026. Claude jest znakiem towarowym Anthropic PBC, GPT jest znakiem towarowym OpenAI. Wzmianka redakcyjna, bez partnerstwa.