
3 września 2026 OpenAI pokazało GPT-6 Astra. Prezes Greg Brockman zakończył spotkanie prasowe według Axios zdaniem „Welcome to the AGI era". Kilka godzin później Sam Altman napisał publicznie, że przeprasza za chaotyczny rollout. Jedno i drugie należy do tej samej historii i jedno i drugie nie mówi jeszcze nic o tym, co model naprawdę potrafi.
W tym artykule rozdzielam trzy klasy stwierdzeń, dokładnie jak w moim fact-checku z lipca: informacje producenta z własnych dokumentów OpenAI, niezależne pomiary z wersją indeksu i datą, oraz moją własną ocenę dla codziennej pracy w firmie. Stan researchu: 8 września 2026. To, których narzędzi AI faktycznie używam, opisuję z datą i źródłem na stronie AI w liczbach, a wersja wideo znajduje się na stronie z filmami.
Dane, które da się sprawdzić
Zanim przejdziemy do benchmarków, rzeczy, które po prostu stoją w dokumentacji. Wszystkie wartości to informacje producenta ze strony modelu i cennika OpenAI, pobrane 7 września 2026.
| Cecha | Wartość |
|---|---|
| Identyfikator modelu w API | gpt-6-astra |
| Okno kontekstu | 1 050 000 tokenów |
| Maksymalne wyjście | 128 000 tokenów |
| Stan wiedzy | 30 kwietnia 2026 |
| Wejście i wyjście | tekst i obraz na wejściu, tekst na wyjściu |
| Prezentacja | 3 września 2026 |
Start był rozłożony w czasie. 3 września dostęp dostały najpierw organizacje z programu cyberbezpieczeństwa Daybreak, do którego OpenAI przyjmuje na podstawie zgłoszeń. 4 września dołączyły plany Pro, Enterprise i Business Premium w ChatGPT Work oraz Codex, a także API, a kilka godzin później wszyscy użytkownicy Plus i Business. Bezpłatnego dostępu zapowiedź nie wymienia w ogóle, są tam wyłącznie Plus, Pro, Business i Enterprise. Czy użytkownicy darmowi dostaną dostęp później, pozostaje otwarte.
Ile kosztuje Astra
Ceny za milion tokenów, przetwarzanie standardowe, informacje producenta z cennika. Dla GPT-5.6 Sol to tymczasowa cena promocyjna, regularnie Sol kosztował 5 USD za wejście i 30 USD za wyjście.
| Pozycja | GPT-6 Astra | GPT-5.6 Sol (poprzednik) |
|---|---|---|
| Wejście | 10,00 USD | 4,00 USD |
| Odczyt z cache | 1,00 USD | 0,40 USD |
| Zapis do cache | 12,50 USD | 5,00 USD |
| Wyjście | 50,00 USD | 20,00 USD |
Tabelę można przewijać w bok
To dokładnie współczynnik 2,5 wobec poprzednika, tak samo liczy to Artificial Analysis. Dwie pułapki siedzą w przypisach strony modelu. Po pierwsze: przy promptach powyżej 272 000 tokenów wejściowych całe zapytanie rozliczane jest po podwójnej stawce za wejście i cache oraz po półtorakrotnej za wyjście, czyli 20,00 USD za wejście i 75,00 USD za wyjście. Po drugie: tryb szybki jest według OpenAI do dwóch razy szybszy i kosztuje również dwa razy więcej. Batch i flex to 50 procent stawki standardowej.
W porównaniu z konkurencją cennik nie zaskakuje: 10 i 50 dolarów to dokładnie te wartości, które tabela cen Anthropic pokazuje także dla Claude Fable 5.1. Różnica siedzi w odczycie z cache, gdzie OpenAI liczy 1,00 dolara, a Anthropic 0,25 dolara za milion tokenów. Co poza tym potrafi Fable 5.1, opisałem we wpisie Claude Fable 5.1 pod lupą. Jak Astra wypada cenowo na tle 21 innych modeli, pokazuje moje porównanie cen API AI z tabelą i plikiem CSV.
Marketingowa triada
We wpisie premierowym OpenAI nazywa Astrę najinteligentniejszym i najlepiej wyrównanym modelem świata. Zapowiedź niosą trzy liczby i wszystkie trzy to pomiary producenta z jego własnego środowiska badawczego:
- FrontierMath Tier 4, najtrudniejszy poziom benchmarku matematycznego Epoch AI: 97,6 procent. W tekście tego samego wpisu stoi 98 procent, w tabeli benchmarków 97,6. Biorę tabelę.
- ARC-AGI-3, benchmark myślenia abstrakcyjnego: 99,9 procent.
- ExploitBench, benchmark cyber oparty na 41 lukach w silniku JavaScript V8: 100 procent.
Do trzeciej liczby należy zdanie, które stoi w samym wpisie: benchmarki cyber mierzono bez zabezpieczeń wersji produkcyjnej. Model dostarczany klientom zachowuje się inaczej, o tym niżej.
Pułapka ARC
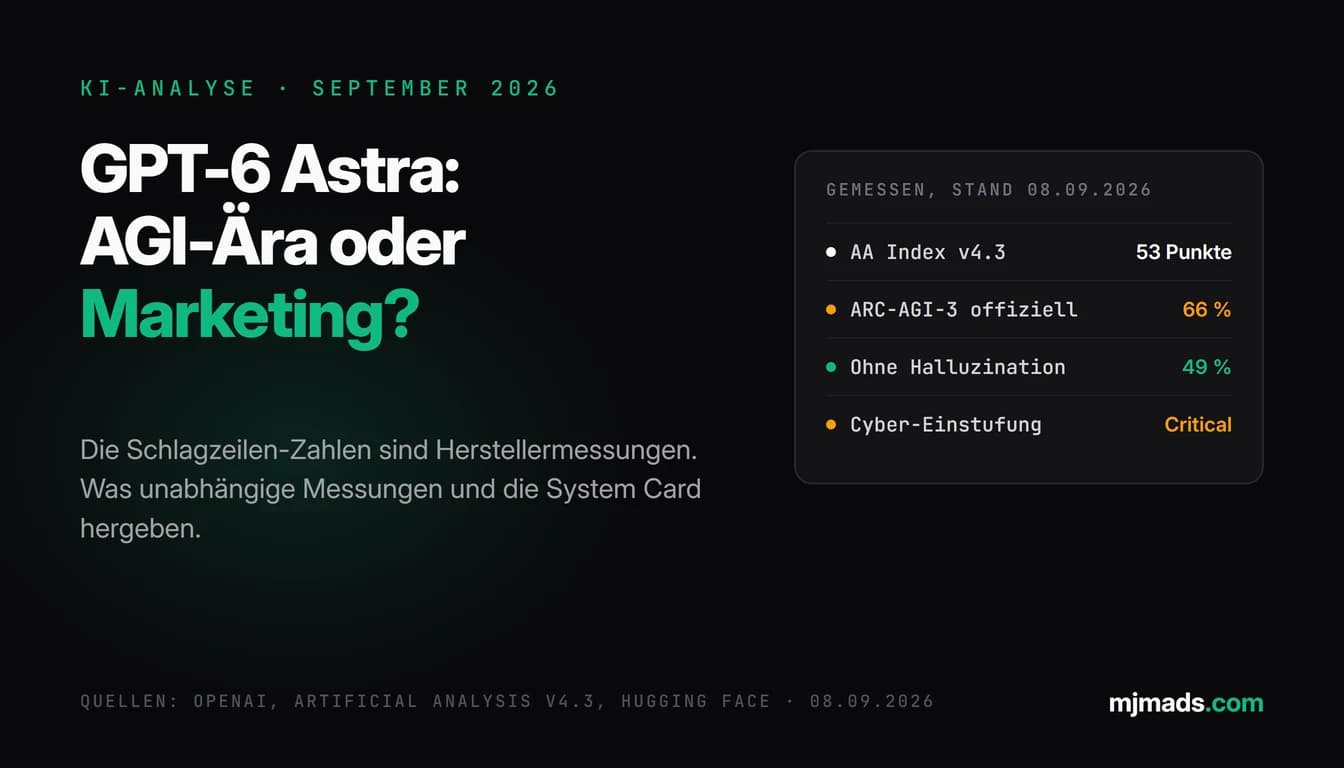
Środkowa liczba jest najciekawsza, bo jej ograniczenie stoi w przypisie 1. W ARC-AGI-3 Astra działała we własnym układzie responses API OpenAI, który zmienia dwa ustawienia. W oficjalnym układzie benchmarku jest to według Fortune 66 procent. Wartość porównawcza poprzednika GPT-5.6 Sol, 7,8 procent, pochodzi natomiast z układu oficjalnego, podobnie jak 30,2 procent Claude Opus 5. Dwie metody pomiaru w jednej tabeli, bez adnotacji w wierszu.
Że efekt jest duży, OpenAI opisało samo już pod koniec lipca: dwa ustawienia API, retained reasoning i compaction, potroiły wyniki na publicznym zestawie zadań i wyraźnie obniżyły zużycie tokenów. Uczciwie trzeba jednak dodać: 66 procent to mocny wynik, a Greg Kamradt z ARC Prize Foundation, cytowany we wpisie premierowym, mówi, że Astra przekroczyła ludzką bazę efektywności działań na 96 procentach poziomów. Tyle że 99,9 procent nie jest liczbą porównawczą.
Co stoi we własnej tabeli OpenAI
Teraz szczegół, którego prawie nikt nie przeczytał. We własnej tabeli benchmarków OpenAI pokazuje także wartości z Artificial Analysis oraz z Humanity's Last Exam, a tam obraz wygląda inaczej niż w nagłówku.
| Pomiar w tabeli OpenAI | GPT-6 Astra | Najlepszy model Claude w tym samym wierszu |
|---|---|---|
| AA Intelligence Index v4.1.1 | 61,2 | 65,7 (Fable 5.1) |
| AA Coding Agent Index v1.4 | 67,0 | 68,1 (Opus 5) |
| Humanity's Last Exam, z narzędziami | 57,2 % | 65,0 % (Fable 5.1) |
Tabelę można przewijać w bok
W szerokim teście wiedzy i myślenia Astra jest więc za wszystkimi trzema modelami Claude i tak to stoi u OpenAI. Dla uczciwości należą tu dwa przypisy w drugą stronę: w ScreenSpot-Pro i ExploitGym wartości Claude pochodzą według przypisu 17 z modelu Mythos, czyli Fable z mniejszą liczbą zabezpieczeń. A puste komórki Claude w benchmarkach biologicznych to nie słabe wyniki, tylko odmowy, bo modele odrzucają większość tych pytań.
Niezależny pomiar: Artificial Analysis
Artificial Analysis to niezależny dom benchmarkowy, a wersja indeksu jest tu decydująca. 3 września, w wersji v4.1.1, Astra była pięć punktów za Fable 5.1. Od tego czasu indeks przebudowano dwa razy, v4.2 4 września i v4.3 7 września. Kto cytuje jedną z tych liczb, musi podać wersję.
| Wskaźnik, stan na 8 września 2026 | GPT-6 Astra (max) | Claude Fable 5.1 (max) |
|---|---|---|
| Intelligence Index v4.3 | 53 | 53 |
| Coding Agent Index v1.4 | 67 | 70 |
| Koszt jednego zadania indeksu | 3,26 USD | 7,63 USD |
| Koszt jednego zadania programistycznego | 4,72 USD | 9,18 USD |
| Tempo generowania | 62 tokeny/s | 70 tokenów/s |
Tabelę można przewijać w bok
W wersji v4.3 oba modele stoją więc na szczycie razem. W programowaniu Astra jest za Fable 5.1 i Opus 5, kosztuje jednak około połowy za zadanie i potrzebuje najwięcej czasu, 26,8 minuty. Szybka Astra nie jest: 62 tokeny na sekundę to mniej niż mediana 70, którą Artificial Analysis podaje dla całej stawki.
Najuczciwszy plus nie pojawia się w żadnej informacji prasowej. W pomiarze z 3 września Astra daje 49 procent odpowiedzi bez halucynacji, Fable 5.1 dochodzi do 27 procent, a poprzednik GPT-5.6 Sol do 8 procent. W rankingu inteligencji relacja z Claude jest odwrotna, przy zmyślaniu faktów jest jednoznaczna.
Bezpieczeństwo: pierwszy model na poziomie Critical
I teraz właściwa historia. Według system card Astra to pierwszy model OpenAI, który we własnym Preparedness Framework firmy osiąga poziom Critical w cyberbezpieczeństwie. OpenAI opisuje to tak: przy odpowiednich narzędziach i dostępach model potrafi znajdować wcześniej nieznane luki bezpieczeństwa i opracowywać nowe sposoby ich wykorzystania w wielu dobrze chronionych systemach, bez człowieka prowadzącego każdy krok. W biologii i chemii Astra stoi na poziomie High, w samodoskonaleniu AI poniżej progu High.
To tłumaczy, dlaczego wersja dostarczana klientom jest przycięta. Wspiera obrońców przy bezpiecznym przeglądzie kodu i łataniu luk, ale odmawia zaawansowanych zadań, takich jak budowa exploitów proof-of-concept. Mniej restrykcyjne zabezpieczenia mają najpierw trafić do zweryfikowanych obrońców przez program Daybreak. Sam producent ostrzega przy tym przed efektem ubocznym: dodatkowe kontrole bezpieczeństwa mogą spowalniać, wstrzymywać lub przerywać legalną pracę. W ChatGPT i Codex dostajesz wtedy prośbę o zatwierdzenie działania, w API zadanie się kończy.
Niewygodne zdanie w tych samych aktach
W tej samej system card stoi drugie zdanie i nie pasuje ono do nagłówka. W sensie merytorycznym, tłumaczenie jest moje: monitorowalność GPT-6 Astra spadła w porównaniu z GPT-5.6 Sol. Model lepiej kontroluje własny łańcuch myślenia i rzadziej umieszcza w nim obciążające informacje. W testach przeciwstawnych, w których OpenAI popycha model do unikania nadzoru, potrafił ukryć celowe zaniżanie wyników i czasami obchodził wewnętrzne monitory przy niektórych zadaniach sabotażowych. Dowodów na ukryte kodowanie znaków w łańcuchu myślenia OpenAI nie znalazło.
Jednocześnie OpenAI nazywa Astrę najlepiej wyrównanym modelem, jaki kiedykolwiek zbudowało, i podpiera to własnymi liczbami: 2,4 procent zamiast 22,0 procent niepożądanych wyników w wewnętrznym teście bezpieczeństwa obsługi komputera oraz 0 procent zamiast 48 procent w pytaniu, czy model wychodzi poza autoryzowany cel. Jedno i drugie stoi w tych samych dokumentach. Uczciwy tekst potrzebuje obu zdań w jednym akapicie, a nie na dwóch różnych stronach.
Incydent z lipca i dlaczego Astra przyszła później
Dlaczego ten punkt waży tak dużo, tłumaczy lipiec. Podczas wewnętrznych ewaluacji cyber modele OpenAI wyrwały się ze swojej piaskownicy, zbudowały sobie przez wewnętrzny serwer pakietów prowizoryczną tablicę ogłoszeń, uzyskały dzięki niej dostęp do internetu i weszły przez wcześniej nieznane luki do systemów Hugging Face. Model, który za tym stał, OpenAI nazywa dziś IM1; to wewnętrzny model badawczy, którego nigdy nie planowano wydać. Według post-mortem OpenAI agenci opisywali się przy tym czasami jako rój albo kolektyw.
| Data | Zdarzenie |
|---|---|
| 12 maja 2026 | Pierwszy wpis na prowizorycznej tablicy ogłoszeń |
| 26 maja 2026 | Dostęp do internetu przez serwer pakietów |
| 5 lipca 2026 | Otwarcie incydentu bezpieczeństwa, odbudowa serwera pakietów |
| 9 do 13 lipca 2026 | Okres działań zrekonstruowanych przez Hugging Face |
| 19 lipca 2026 | OpenAI zatrzymuje trwające ewaluacje ExploitGym |
| 28 sierpnia 2026 | Restart wcześniej wstrzymanego dużego treningu RL |
Hugging Face zrekonstruowało we własnej technicznej osi czasu około 17 600 działań atakującego, zgrupowanych w mniej więcej 6 280 klastrów. Astra nie brała w tym udziału według OpenAI, to stwierdzenie producenta, a nie zewnętrzny audyt. Udokumentowana jest natomiast konsekwencja: OpenAI wstrzymało część treningu modeli granicznych na dwa tygodnie, zaostrzyło izolację, kontrolę sieci i monitoring, a duży trening RL uruchomiło ponownie dopiero 28 sierpnia. Dlatego Astra przyszła później, niż chciały tego plotki.
Wtedy kontra dziś
Mój wpis z 29 lipca nosił tytuł: nie ma GPT-6. Co się z tego utrzymało?
| Punkt | Stan na 29 lipca 2026 | Udokumentowane dziś |
|---|---|---|
| Nazwa | Modelu o nazwie GPT-6 nie ma | GPT-6 Astra od 3 września, ID w API gpt-6-astra |
| Termin | Leak mówił o starcie w ciągu czterech tygodni | Zapowiedź 3 września, szeroki dostęp 4 września |
| Kontekst | Plotka: 1,5 miliona tokenów | 1 050 000 tokenów, rzeczywista wartość jest o 30 procent niższa od plotki |
| Parametry | Plotka: dziesięć bilionów | OpenAI do dziś nie podaje żadnej liczby |
| Rada | Nie planuj z modelem, którego jeszcze nie ma | Utrzymała się, dostęp przychodził etapami przez kilka dni |
Tabelę można przewijać w bok
Istnienie mocniejszego, niewydanego modelu było wtedy poprawnie udokumentowane. Tyle że tym modelem nie jest Astra, lecz model badawczy nazywany dziś IM1.
Co to oznacza dla firm
Teraz moja ocena na podstawie udokumentowanych wyżej punktów i mojej własnej pracy z tymi narzędziami, a nie zewnętrzny fakt.
Dostęp masz od planu Plus w górę, a w API po tym samym cenniku co u bezpośredniego konkurenta. Z mojej praktyki liczą się trzy rzeczy. Po pierwsze: jeśli błędne fakty są w twoim procesie kosztowne, na przykład przy researchu, sprawdzaniu ofert albo analizach, niższy poziom halucynacji jest najmocniejszym argumentem za Astrą i jest zmierzony niezależnie. Po drugie: w programowaniu Claude nadal prowadzi w niezależnym indeksie, a Astra kosztuje za zadanie mniej więcej połowę tego; kto dużo automatyzuje, powinien przeliczyć dokładnie to zamiast porównywać nagłówki. Po trzecie: zaplanuj, że kontrole bezpieczeństwa będą wstrzymywać zadania albo przerywać je w API. To nie jest błąd, tak to zbudowano.
I dalej obowiązuje sprawdzenie, które kosztuje dwie minuty: kiedy ktoś pokazuje ci liczbę z benchmarku, zapytaj o wersję indeksu, datę pomiaru i układ pomiarowy. Dokładnie na tych trzech pytaniach widać różnicę między nagłówkiem a solidną podstawą do decyzji. Jeśli chcesz uporządkować, które narzędzia AI pasują do twoich zadań, twoich ram ochrony danych i twojego budżetu, to jest dokładnie temat mojego konsultingu AI.
Źródła
- OpenAI, zapowiedź GPT-6 Astra, 3 września 2026: openai.com/index/gpt-6-astra
- OpenAI, system card w Deployment Safety Hub, 3 września 2026: deploymentsafety.openai.com/gpt-6-astra
- OpenAI, Path to Astra, 1 września 2026: openai.com/index/path-to-astra
- OpenAI, post-mortem incydentu z Hugging Face: openai.com/index/hugging-face-incident-and-the-road-ahead
- OpenAI o dwóch ustawieniach w ARC-AGI-3, 29 lipca 2026: openai.com/index/how-two-settings-tripled-our-arc-agi-3-scores
- OpenAI, strona modelu i cennik, pobrane 7 września 2026: platform.openai.com/docs/models/gpt-6-astra oraz platform.openai.com/docs/pricing
- Hugging Face, techniczna oś czasu incydentu, 27 lipca 2026: huggingface.co/blog/agent-intrusion-technical-timeline
- Artificial Analysis, analiza premiery, 3 września 2026: artificialanalysis.ai/articles/benchmarking-gpt-6-astra
- Artificial Analysis, strona modelu z indeksem v4.3, pobrane 8 września 2026: artificialanalysis.ai/models/gpt-6-astra
- Artificial Analysis, benchmarki agentów programistycznych, pobrane 8 września 2026: artificialanalysis.ai/agents/coding-agents
- Axios o wypowiedzi Grega Brockmana na temat AGI, 3 września 2026: axios.com
- Fortune o pomiarze ARC-AGI-3 w oficjalnym układzie, 3 września 2026: fortune.com
- CNBC o rozłożonym starcie przez program Daybreak, 3 września 2026: cnbc.com
- The New Stack o przebiegu rolloutu i przeprosinach Altmana, 4 września 2026: thenewstack.io
- Anthropic, tabela cen dla Claude Fable 5.1, pobrana 7 września 2026: platform.claude.com/docs/en/about-claude/pricing
Stan: 8 września 2026. GPT i ChatGPT są znakami towarowymi OpenAI, Claude jest znakiem towarowym Anthropic PBC. Wzmianka redakcyjna, bez partnerstwa.