Claude Opus 5 ist seit dem 24. Juli 2026 öffentlich. Dieser Artikel zieht Bilanz nach fünf Tagen, Datenstand aller Zahlen ist der 28. Juli 2026, die Screenshots dazu stammen vom 29. Juli. Fünf Tage sind zu kurz für ein Urteil und lang genug für ein Stimmungsbild. Um die Release-Benchmarks geht es hier ausdrücklich nicht, die stehen im Benchmark-Artikel zum Release. Hier geht es um den Riss zwischen Messung und Arbeitsalltag.
Diesen Riss kann man in einem einzigen Beitrag zeigen. Die Testerin Claire Vo hat sieben Modelle verdeckt gegeneinander laufen lassen und Opus 5 auf Platz 1 gesetzt, vor allen sechs anderen. Im selben Post auf X vom 24. Juli schreibt sie im Original: „I hate working with it." Zwei Zeilen weiter, im selben Post: „in a blind taste test, I ranked it above every other model (even Fable and my beloved GPT-5.6)". Genau dieser Widerspruch ist der Befund nach fünf Tagen, nicht die Rangliste.
Fünf Tage, keine Woche
Bevor die Zahlen kommen, die Methode. Ich sortiere jede Quelle in dieser Bilanz in eine von zwei Schubladen, weil die Etiketten in der Berichterstattung ständig verrutschen.
Herstellerangabe sind Anthropics eigene Veröffentlichungen, also Ankündigung, System Card und Dokumentation. Unabhängig erhoben sind Werte, die Dritte selbst gemessen haben, hier Artificial Analysis, das blinde Nutzervotum der Arena-Rangliste, der Blindtest von Claire Vo und der Code-Review-Test von CodeRabbit. Als unabhängige Messung habe ich Artificial Analysis auch im Benchmark-Artikel zum Release geführt. Meine eigene Einschätzung halte ich davon getrennt und kennzeichne sie ausdrücklich als solche.
Welche Modelle ich in der täglichen Arbeit tatsächlich einsetze und in welchem Umfang, halte ich offen auf der Seite KI in Zahlen fest. Dieselbe Bilanz gibt es als Video, es steht oben auf dieser Seite und in der Videoübersicht.
61 zu 60, und wer das gemessen hat
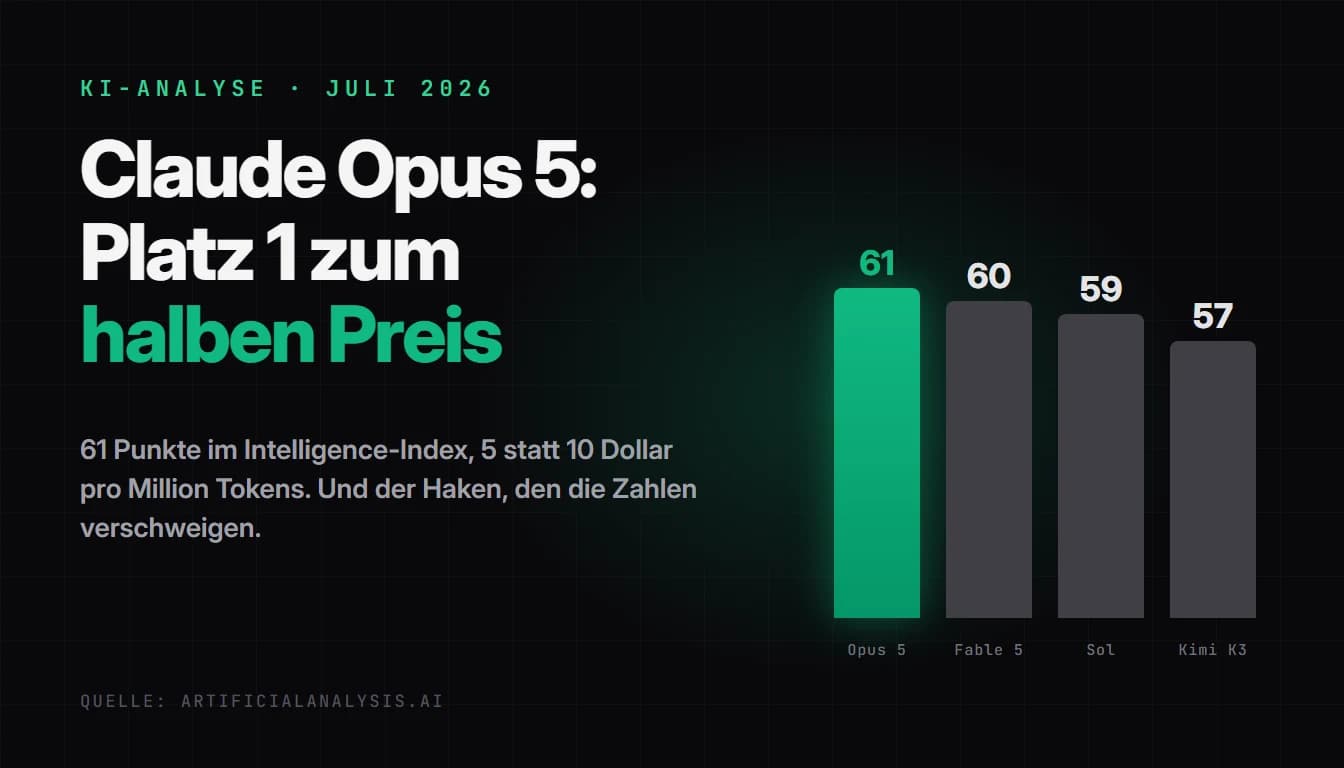
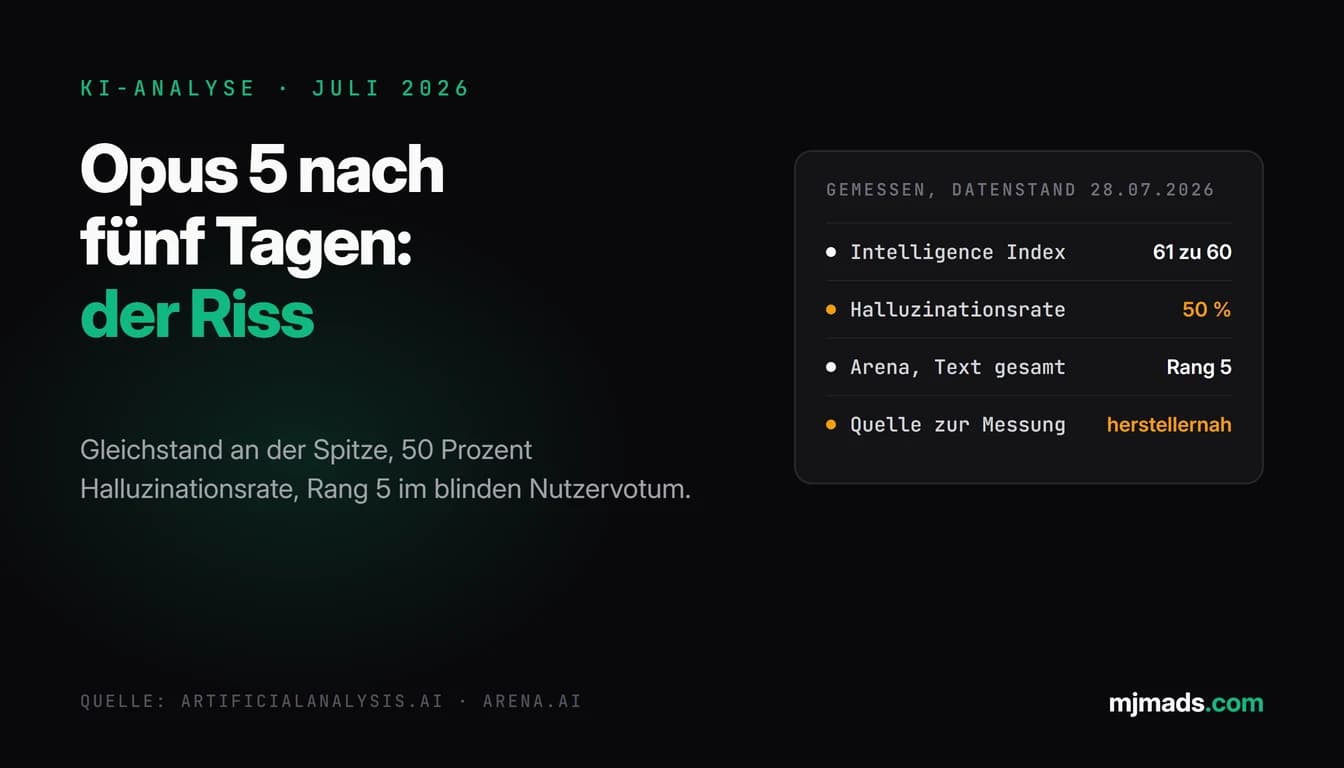
Artificial Analysis misst für Claude Opus 5 in der höchsten Effort-Stufe 61 Punkte im Intelligence Index und für Claude Fable 5 60 Punkte. Entscheidend ist, wie die Quelle das selbst einordnet. Sie nennt das Ergebnis wörtlich „effectively tied with Claude Fable 5 (max, 60)". Praktisch Gleichstand also, ausdrücklich kein Sieg. Wer aus einem Punkt Abstand eine Rangfolge baut, baut sie gegen die Formulierung der Messstelle.
Der zweite Satz aus derselben Quelle gehört der Transparenz halber dazu: „We supported Anthropic to evaluate Claude Opus 5 ahead of release". Artificial Analysis misst selbst und ist unabhängig, hat Anthropic nach eigener Angabe aber vor der Veröffentlichung bei der Evaluierung unterstützt. An den Zahlen ändert das nichts. Unabhängig heißt hier: eigene Messung, nicht neutraler Schiedsrichter. Wie schnell aus einer Benchmark-Zahl eine Debatte über die Messung selbst wird, habe ich in der Benchmark- und Cheating-Debatte um GPT-5.6 Sol beschrieben.
Nebenbei ist die Konstellation weiterhin bemerkenswert, weil Fable 5 das teurere Modell aus demselben Haus ist. Was aus dem Comeback von Fable 5 geworden ist, wird man erst über Wochen sehen, nicht über fünf Tage.
Die Halluzinationsrate von 50 Prozent, und was sie nicht heißt
Dieselbe Auswertung nennt eine Halluzinationsrate von 50 Prozent, 14 Punkte höher als bei Claude Opus 4.8. Diese Zahl wird fast überall falsch gelesen, deshalb hier die Definition zuerst.
Gemeint ist nicht, dass jede zweite Antwort falsch ist. Artificial Analysis definiert die Rate auf dem Wissenstest AA-Omniscience als incorrect geteilt durch incorrect plus partial plus not attempted. Gezählt werden also ausschließlich die nicht korrekten Antworten, und von diesen entfällt die Hälfte auf falsche Rateversuche statt auf ein Auslassen der Frage. Es geht um das Verhalten bei Nichtwissen, nicht um die Trefferquote insgesamt.
Die Gegenrichtung steht im selben Text und gehört genauso dazu: Opus 5 erreicht 7 Punkte mehr Faktenwissen als Opus 4.8. Zusammengenommen ergibt das ein klares Verhaltensprofil. Das Modell weiß mehr und antwortet häufiger, auch wenn es unsicher ist. Für die Praxis heißt das dasselbe wie schon beim Release: Faktenbehauptungen gehören gegengeprüft, bevor sie in Kundentexte, Angebote oder Reports wandern.
Rang 5 im blinden Nutzervotum
Der zweite Datenpunkt ist ein blindes Nutzervotum, die Arena-Rangliste. In der Gesamtwertung für Text steht Claude Opus 5 in der Stufe max mit 1495 Punkten auf Rang 5. Davor liegen Claude Fable 5 mit 1508, Claude Opus 4.6 Thinking mit 1505, Claude Opus 4.7 Thinking mit 1502 und Claude Opus 4.6 mit 1497. Alle vier stammen von Anthropic selbst, das neueste Modell steht im Nutzervotum also hinter drei eigenen Vorgängern.
Dazu die Einschränkung, ohne die der Rang wenig aussagt. Das Konfidenzintervall liegt bei plus minus 12, bei den etablierten Modellen der Liste bei plus minus 4 bis 6. Der Wert ist also deutlich unsicherer als die Werte darüber, und Arena weist ihn im Tooltip als auf Tests vor der Veröffentlichung beruhend aus. Ein Datenstand steht auf der Seite nicht, mein Abruf war der 29. Juli 2026.
Platz 1 im Blindtest, und trotzdem kein Lob
Den schärfsten Einzelbefund liefert Claire Vo. Sie hat sieben Modelle verdeckt gegeneinander getestet, über sechs Aufgabentypen, veröffentlicht am 25. Juli auf ChatPRD. Opus 5 gewinnt diesen Test, vor allen sechs anderen Modellen, auch vor Fable 5.
Im selben Text nennt sie die Ausgaben „Claude Slop" und das Modell „neurotic" und „timid". Auf der Seite steht sinngemäß, es sei der meistverabscheute Kollege und liefere trotzdem die beste Arbeit. Der schärfere Originalwortlaut steht nicht dort, sondern im eingangs zitierten X-Post vom 24. Juli, in dem beide Aussagen in einem einzigen Beitrag stehen.
Das ist kein Widerspruch im Denken der Testerin, sondern ein Hinweis auf zwei verschiedene Größen. Ergebnisqualität und Arbeitserlebnis fallen bei diesem Modell auseinander. Wer nur Ranglisten liest, bekommt davon nichts mit.
CodeRabbit: weniger Fehler gefunden, öfter richtig
Messbar wird derselbe Riss bei CodeRabbit, einem kommerziellen Code-Review-Anbieter, der seine Methodik offengelegt hat. Der kommerzielle Hintergrund gehört dazugesagt, die Zahlen sind es trotzdem wert, genau gelesen zu werden.
Opus 5 findet in diesem Test in der Stufe x-high 55,2 Prozent der bekannten Fehler, die Vergleichsbasis liegt bei 61,1 Prozent. Wichtig ist, was diese Basis ist: kein Konkurrenzmodell, sondern CodeRabbits eingespielter Produktions-Mix, also ein über lange Zeit optimiertes System. Der Vergleich fällt damit härter aus, als er auf den ersten Blick wirkt.
Bei der Präzision dreht sich das Bild, und zwar in beide Richtungen. Bei den umsetzbaren Befunden liegt Opus 5 öfter richtig, 39,3 gegen 35,2 Prozent. Auf die gesamte Ausgabe gerechnet kippt es zurück, 28,6 gegen 32,8 Prozent. Dazu kommen 92 Kleinigkeiten statt 23 und laut derselben Ergebnistabelle rund 60.500 statt rund 40.500 Input-Tokens. Das Fazit des Anbieters lautet sinngemäß: ein Spezialist, nicht der alleinige Reviewer. Die Ausführlichkeit, die schon beim Release auffiel, taucht hier ein zweites Mal auf, diesmal in einer Messung ohne Beteiligung des Herstellers. Getragen wird das von den 92 Kleinigkeiten statt 23; die höhere Zahl an Input-Tokens gehört zur Eingabeseite und sagt über den Umfang der Ausgabe nichts.
Für Claude-Code-Nutzer: Anweisungen löschen statt ergänzen
Jetzt der Teil, der im Alltag am schnellsten etwas ändert. Anthropic empfiehlt in der eigenen Dokumentation zum Prompting von Opus 5, bestimmte Prüf-Anweisungen aus alten Prompts zu entfernen, statt neue hinzuzufügen. Genannt werden unter anderem Formulierungen wie doppelt prüfen, vor dem Antworten erneut verifizieren, für jede nicht triviale Aufgabe einen abschließenden Verifikationsschritt einbauen oder einen Subagenten zur Kontrolle einsetzen. Die Begründung der Doku: Opus 5 verifiziert seine Arbeit von sich aus, doppelte Aufforderungen dazu erzeugen nur zusätzlichen Aufwand.
Aus meiner Praxis ist das der Punkt, an dem sich alte Projektdateien am ehesten rächen. Wer über Monate Prüf-Zeilen in eine Prompt- oder Projektdatei geschrieben hat, hat jetzt eine Aufräumaufgabe statt einer Erweiterungsaufgabe. Das ist ungewohnt, weil Modellwechsel sonst meistens in die andere Richtung gehen.
Man könnte daraus einen Migrationsschock lesen. Die Doku gibt das nicht her. Dort steht ausdrücklich, das Modell laufe mit bestehenden Prompts für Claude Opus 4.8 gut. Bestätigt wird in derselben Doku allerdings genau die Kritik, die auch aus der Community kommt: längere Antworten, längere geschriebene Dateien, mehr Selbstkommentierung und ein ausgeweiteter Aufgabenumfang.
Die Proportionen: laut ist kein Mehrheitsbild
Zur Lautstärke gehört eine Größenangabe, sonst wird jeder wütende Beitrag zum Trend. Der Ankündigungs-Thread zu Opus 5 auf Hacker News liegt bei rund 1.700 Punkten, der Thread, der Opus 5 ein wirklich schlechtes Modell nennt, bei gut 50.
Daraus folgt kein Mehrheitsbild, und zwar in keine Richtung. Punkte auf eine Ankündigung sind kein Zustimmungsvotum zum Modell, sondern ein Aufmerksamkeitswert. Und ein kleiner Kritik-Thread widerlegt weder die Kritik noch belegt er sie. Beides sind Stimmungsindikatoren, keine Messungen, und genau so führe ich sie hier.
Was ich nicht geprüft habe
Zur Ehrlichkeit gehört die Grenze der eigenen Recherche. Drei Punkte davon sind mir wichtig genug, um sie zu nennen.
Erstens habe ich die Reddit-Stimmung nur über einen Aggregator gesehen und keine einzige Upvote-Zahl von dort übernommen. Zweitens habe ich von der Arena-Rangliste ausschließlich die Gesamtwertung für Text ausgewertet, nicht die Teilranglisten. Ein Modell kann dort in einzelnen Kategorien deutlich anders stehen, und ich behaupte über diese Kategorien nichts. Drittens sind fünf Tage schlicht kein Beobachtungszeitraum, und mehrere der hier zitierten Berichte beruhen auf wenigen Tagen Nutzung.
Meine Einordnung nach fünf Tagen
Das Folgende ist meine Einschätzung auf Basis der oben belegten Zahlen und meiner eigenen Arbeit mit diesen Werkzeugen, kein externer Fakt.
Das stabilste Muster über alle Quellen hinweg ist die Aufteilung nach Aufgabentyp. Bei eng abgegrenzten Aufgaben liest sich die Datenlage gut: Snorkel AI meldet für Opus 5 den besten Wert bei Fehlersuche und Performance-Analyse, der Blindtest von Claire Vo sieht es beim Frontend vorn, und bei den umsetzbaren Befunden im CodeRabbit-Test liegt es öfter richtig als die Vergleichsbasis. Bei langen, offenen Aufgaben lesen sich die Berichte gemischt, und die Kritikpunkte wiederholen sich auffällig: mehr Text, mehr Umfang, mehr Eigeninitiative als bestellt. Auch das Portal leadwithai beschreibt längere Arbeiten als weniger ambitioniert.
Praktisch heißt das für mich zweierlei. Erstens lohnt es sich, Aufgaben enger zu schneiden, statt einen langen Auftrag am Stück zu geben. Zweitens lohnt der Blick in die eigenen Prompt- und Projektdateien, weil dort seit Jahren Anweisungen stehen, die dieses Modell nicht mehr braucht. Beides ist überschaubarer Aufwand, und aus meiner Praxis heraus macht es sich schnell bemerkbar.
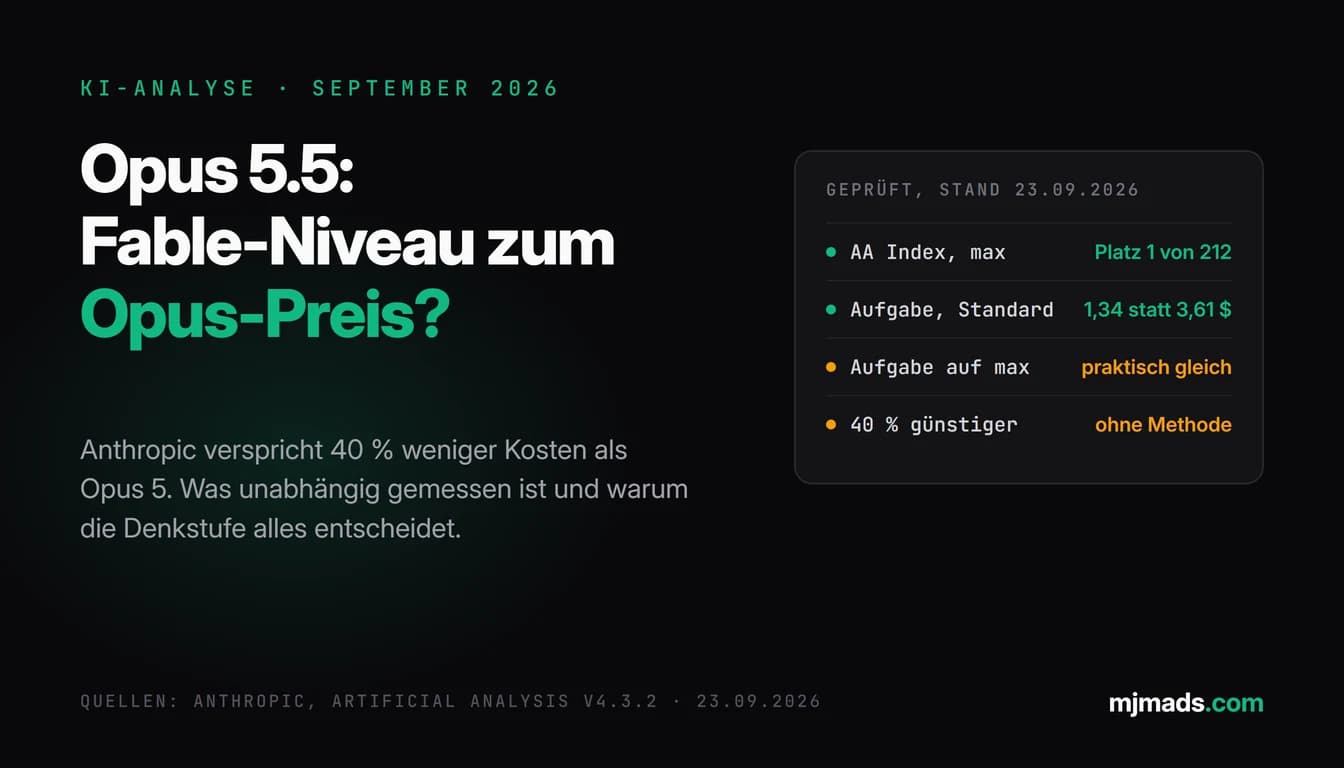
Und ich bleibe bei der Zurückhaltung, mit der dieser Artikel angefangen hat. Ein Punkt Abstand in einer unabhängig erhobenen Wertung ist kein Sieg, ein fünfter Platz mit breitem Konfidenzintervall ist keine Niederlage, und ein einzelner wütender Thread ist kein Meinungsbild. Wer nach fünf Tagen ein Endurteil verkauft, verkauft eine Meinung als Messung. Wenn du für dein Unternehmen sortieren willst, welches Modell zu welchen Aufgaben, welchem Datenschutz-Rahmen und welchem Budget passt, ist genau das Thema meiner KI-Beratung. Für den Blick auf die offene Konkurrenz lohnt außerdem der Beitrag zu Kimi K3. Wie sich der Nachfolger Claude Opus 5.5 schlägt, prüfe ich im Check zu Claude Opus 5.5.
Quellen
- Anthropic, Ankündigung Claude Opus 5: anthropic.com/news/claude-opus-5
- Anthropic, Prompting-Doku zu Claude Opus 5: platform.claude.com
- Artificial Analysis, Artikel zu Opus 5: artificialanalysis.ai/articles/opus-5
- Artificial Analysis, AA-Omniscience und Metrik-Definition: artificialanalysis.ai/evaluations/omniscience
- Artificial Analysis auf X zur Unterstützung vor dem Release: x.com/ArtificialAnlys
- Arena, Text-Rangliste: arena.ai/leaderboard
- Claire Vo, Blindtest auf ChatPRD: chatprd.ai
- Claire Vo auf X, 24.07.2026: x.com/clairevo
- CodeRabbit, Modell-Review zu Opus 5: coderabbit.ai/blog/opus-5-model-review
- Snorkel AI, Fehleranalyse zu Opus 5: snorkel.ai
- leadwithai, geteilte Testberichte: leadwithai.co
- Hacker News, Ankündigungs-Thread: news.ycombinator.com
- Hacker News, Kritik-Thread: news.ycombinator.com
Stand der Zahlen: 28. Juli 2026, Screenshot-Abruf 29. Juli 2026