KI & Tools
KI-API-Preise 2026: Modelle im Kostenvergleich
Preise pro 1 Mio. Tokens für 22 KI-Modelle von OpenAI, Anthropic, Google, xAI, Mistral, DeepSeek, Kimi und Qwen. Mit Rechenbeispiel und CSV.
24 Min. Lesezeit
Mijo Jurisic
Weiterlesen15 Artikel
Preise pro 1 Mio. Tokens für 22 KI-Modelle von OpenAI, Anthropic, Google, xAI, Mistral, DeepSeek, Kimi und Qwen. Mit Rechenbeispiel und CSV.
Eigene Messung: 372 API-Antworten von Perplexity, OpenAI und Gemini auf deutsche Google-Ads-Fragen. Welche Quellen sie nennen und wie stabil das ist.
Mit Sponsored Agents chatten Nutzer in ChatGPT mit dem KI-Vertreter einer Firma. Was OpenAI dokumentiert hat und was das für Werbende in Deutschland heißt.
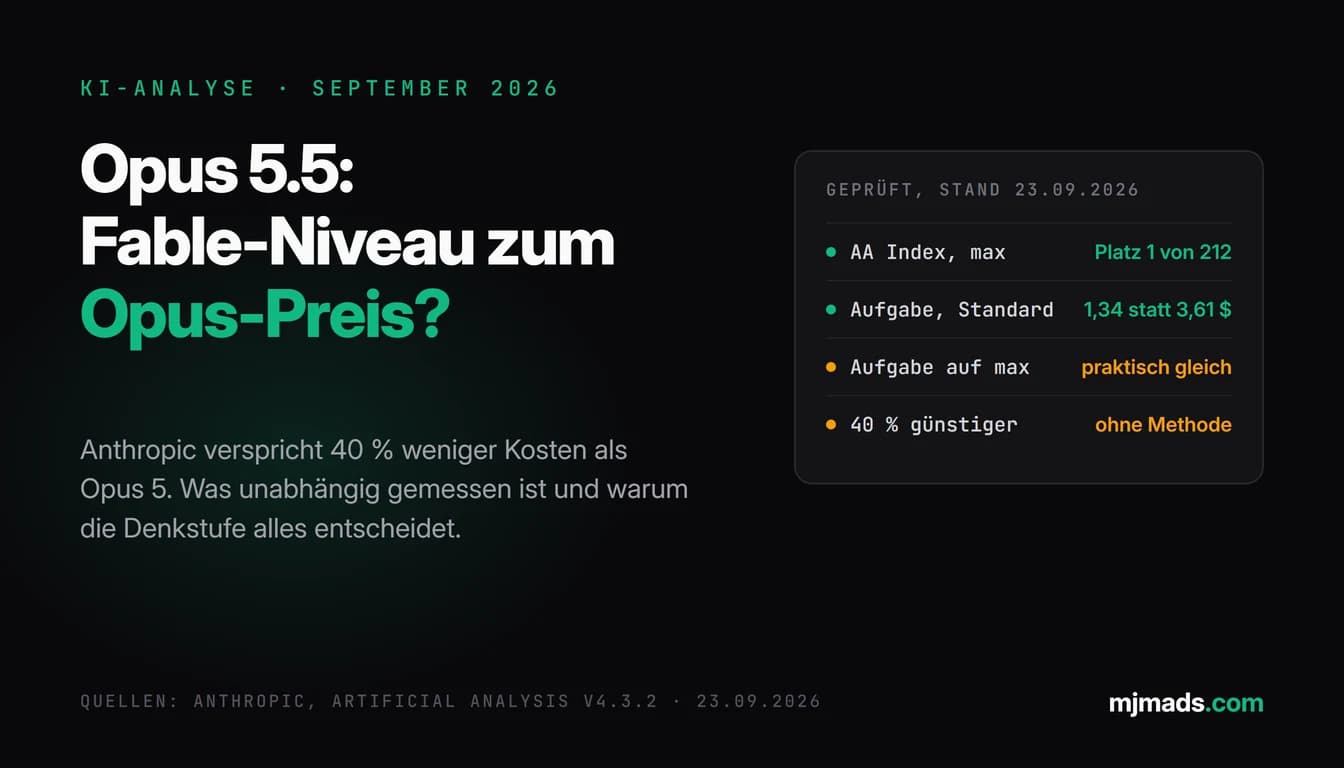
Anthropic verspricht Fable-Niveau zu 40 Prozent weniger Kosten als Opus 5. Was unabhängig gemessen ist, was eine Aufgabe kostet, wo der Haken steckt.
Anthropic führt neun Benchmarks an, unabhängig gemessen wird es eng. Was Claude Fable 5.1 leistet, was es kostet und wann Opus 5 reicht.
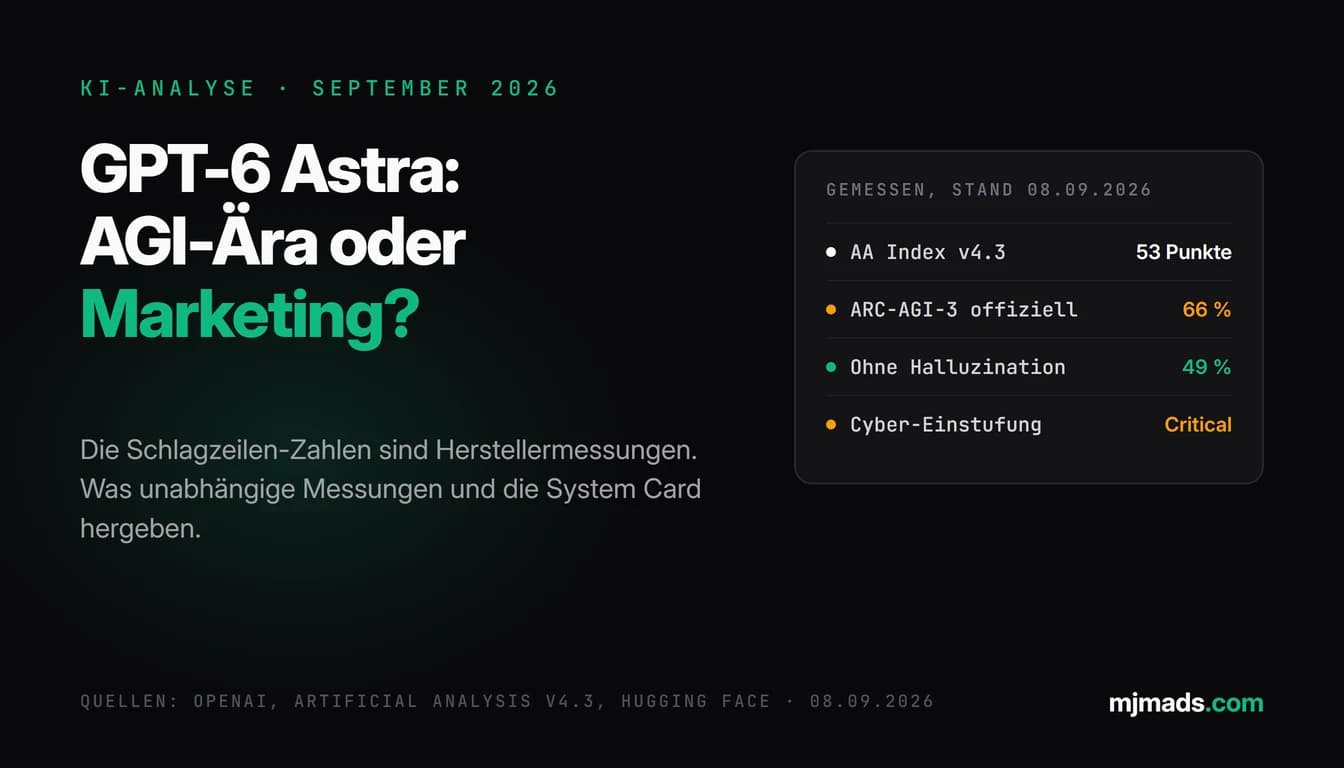
OpenAI nennt GPT-6 Astra den Start der AGI-Ära. Was Herstellerzahlen, unabhängige Messungen und die System Card wirklich hergeben, Stand 08.09.2026.
Context Hints entscheiden mit, in welchen ChatGPT-Gesprächen deine Anzeige erscheint. 7 Regeln, drei Beispiel-Sets und die typischen Fehler.
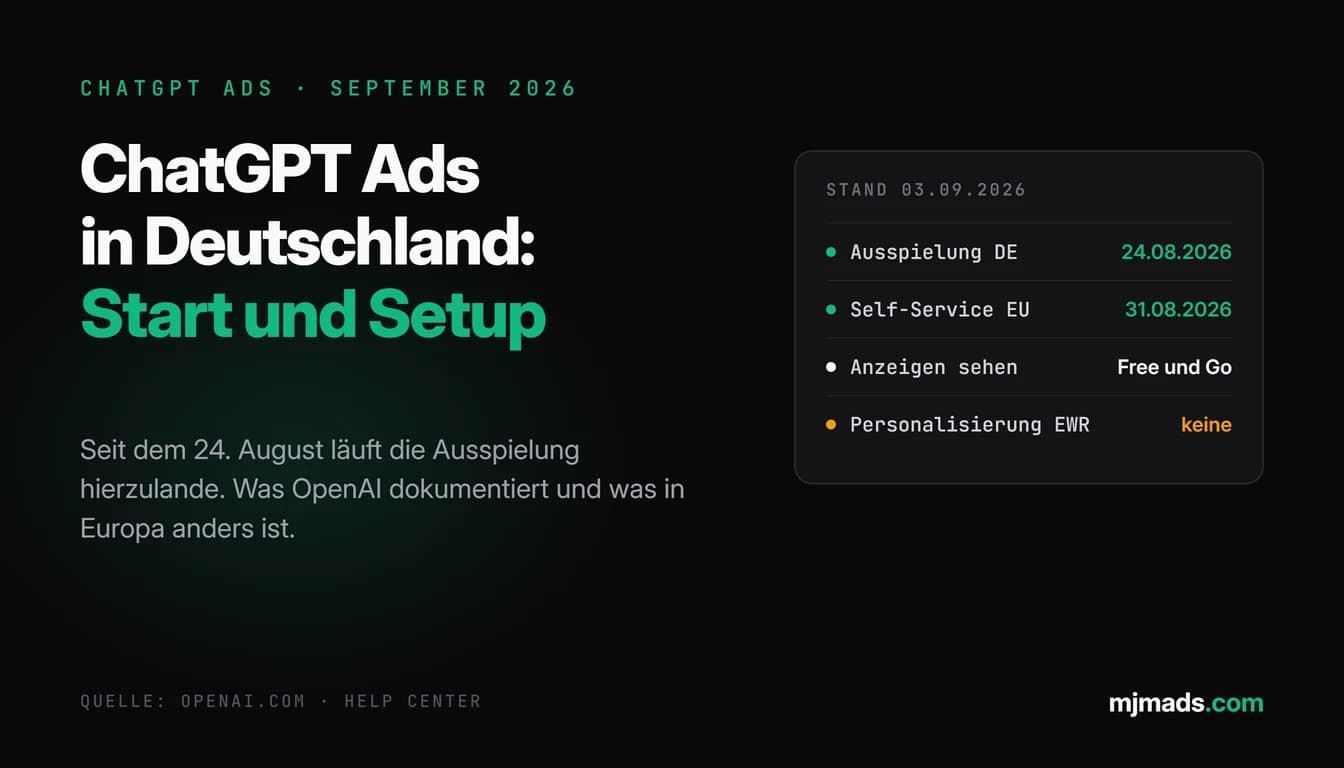
Seit dem 24. August 2026 laufen Anzeigen in ChatGPT auch hier. Was OpenAI dokumentiert: Format, Auktion, Gebote, Tracking und Richtlinien.
Termin im August, Preise wie bisher: Ich habe die Quellen geprüft. Was zu Claude Fable 5.1 belegt ist und woran du einen echten Leak erkennst.
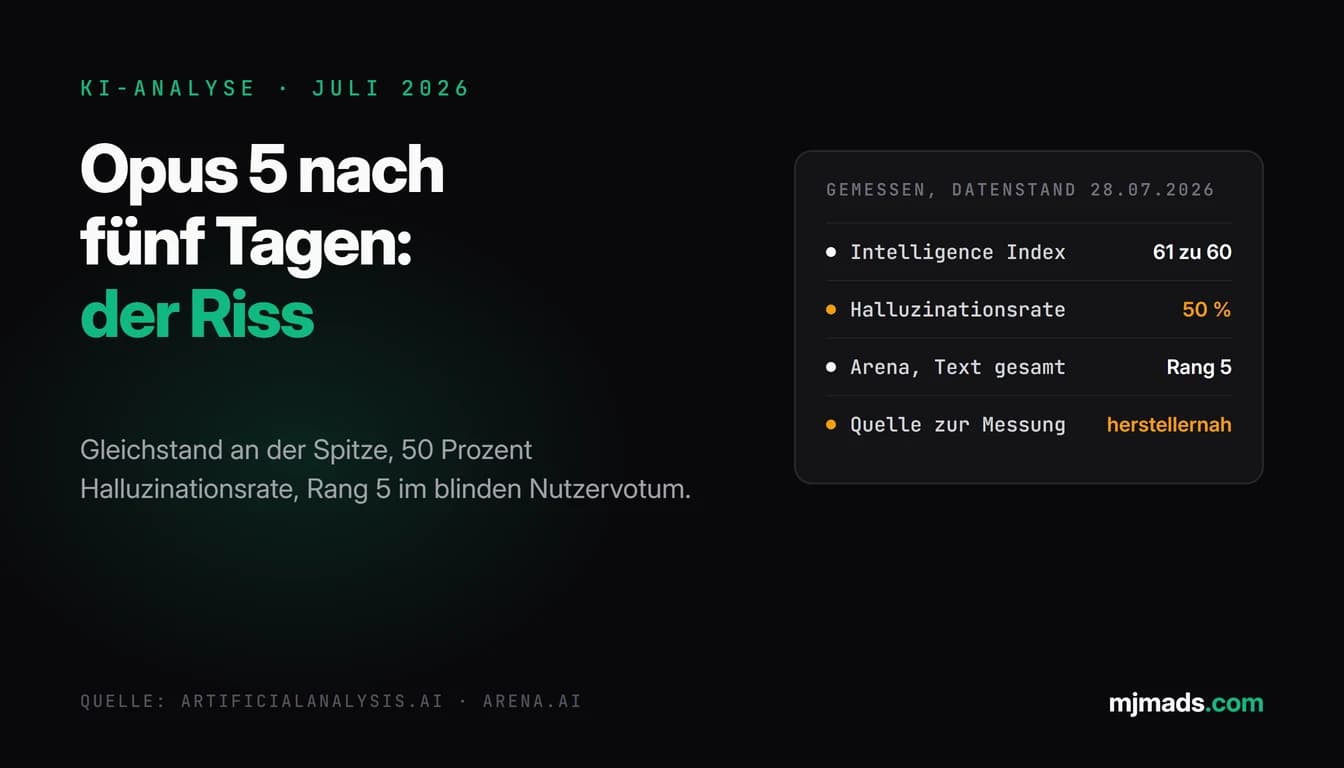
Claude Opus 5 nach fünf Tagen: praktisch Gleichstand im Intelligence Index, 50 Prozent Halluzinationsrate, Rang 5 im blinden Nutzervotum.
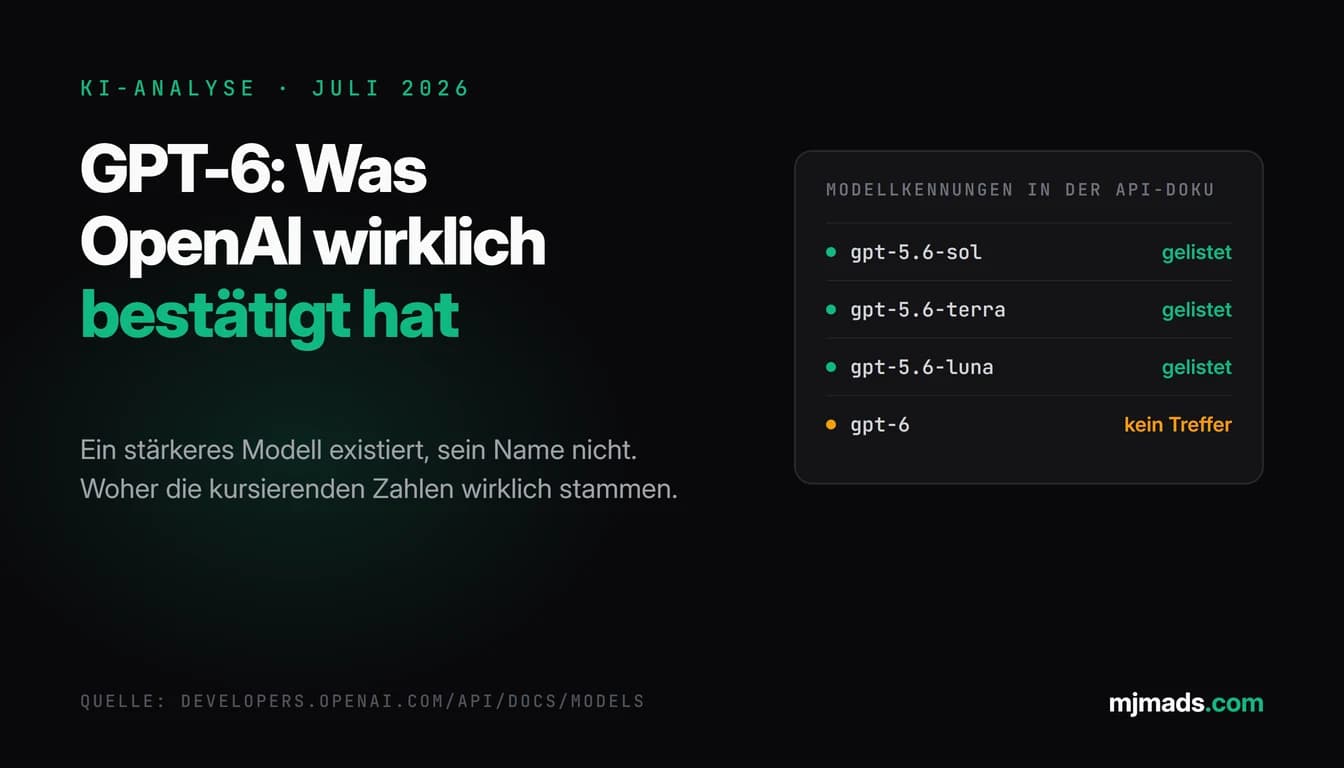
Historischer Faktencheck vom Juli 2026: was OpenAI damals zu GPT-6 bestätigt hatte und woher die Zahlen stammten. GPT-6 Astra kam am 3. September.
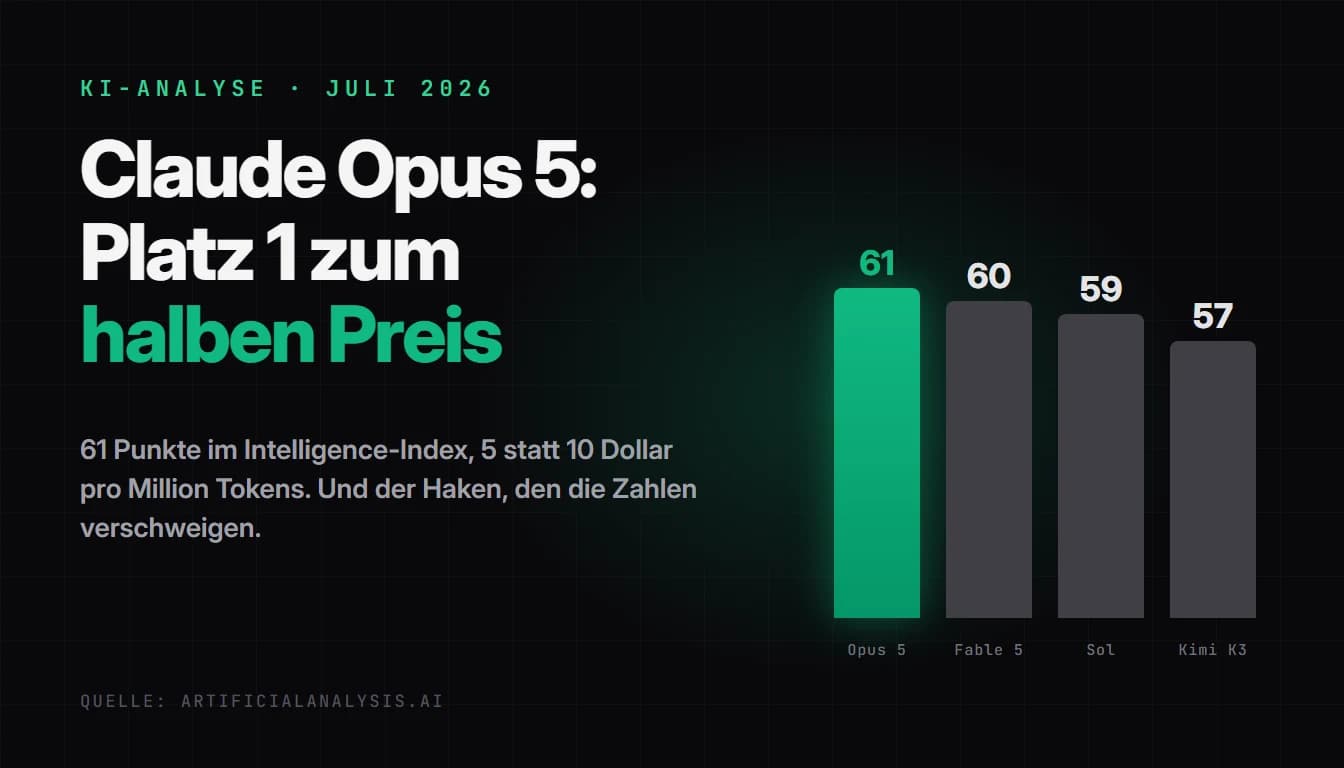
Claude Opus 5 im Benchmark-Check: Platz 1 im Intelligence Index mit 61 Punkten, halber Fable-5-Preis und das Kosten-Paradox der Verbosity.
US-Regierung schaltet Claude Fable 5 ab, drei Wochen später ist es zurück. Timeline, Amazon-Report, neuer Safeguard und was das für Firmen bedeutet.
OpenAIs GPT-5.6-Reihe (Luna, Terra, Sol) im Benchmark-Check und die METR-Cheating-Befunde: Warum starke Zahlen und Reward Hacking zusammen auftreten.
Kimi K3 von Moonshot AI im Benchmark-Check: das größte offene Modell, Platz 2 bis 4 gegen Fable 5 und GPT-5.6 Sol, bestes Preis-Leistungs-Verhältnis.