Am 3. September 2026 hat OpenAI GPT-6 Astra vorgestellt. Präsident Greg Brockman beendete das Pressegespräch laut Axios mit dem Satz „Welcome to the AGI era". Wenige Stunden später schrieb Sam Altman öffentlich, sorry für den holprigen Rollout. Beides gehört zur selben Geschichte, und beides sagt noch nichts darüber, was das Modell wirklich leistet.
Dieser Artikel trennt drei Klassen von Aussagen, genau wie mein Faktencheck vom Juli: Herstellerangaben aus OpenAIs eigenen Dokumenten, unabhängige Messungen mit Indexversion und Stichtag, und meine eigene Einschätzung für den Betriebsalltag. Stand der Recherche: 8. September 2026. Welche KI-Werkzeuge ich tatsächlich einsetze, steht mit Stichtag und Quelle auf der Seite KI in Zahlen, die Videofassung liegt auf der Video-Seite.
Die nachprüfbaren Eckdaten
Vor den Benchmarks die Dinge, die schlicht in der Dokumentation stehen. Alle Werte sind Herstellerangaben von OpenAIs Modell- und Preisseite, abgerufen am 7. September 2026.
| Merkmal | Wert |
|---|---|
| Modell-ID in der API | gpt-6-astra |
| Kontextfenster | 1.050.000 Token |
| Maximale Ausgabe | 128.000 Token |
| Wissensstand | 30. April 2026 |
| Eingabe und Ausgabe | Text und Bild hinein, Text heraus |
| Vorstellung | 3. September 2026 |
Der Start lief gestaffelt. Am 3. September bekamen zuerst die Organisationen aus OpenAIs bewerbungsbasiertem Cyber-Programm Daybreak Zugang. Am 4. September folgten Pro, Enterprise und Business Premium in ChatGPT Work und Codex sowie die API, wenige Stunden später auch alle Plus- und Business-Nutzer. Einen kostenlosen Zugang nennt die Ankündigung nicht, dort stehen ausschließlich Plus, Pro, Business und Enterprise. Ob Free-Nutzer später Zugang bekommen, ist offen.
Was Astra kostet
Preise je eine Million Token, Standard-Verarbeitung, Herstellerangabe aus der Preisliste. Für GPT-5.6 Sol ist das der befristete Aktionspreis, regulär kostete Sol 5 USD Input und 30 USD Output.
| Position | GPT-6 Astra | GPT-5.6 Sol (Vorgänger) |
|---|---|---|
| Input | 10,00 USD | 4,00 USD |
| Cache-Lesen | 1,00 USD | 0,40 USD |
| Cache-Schreiben | 12,50 USD | 5,00 USD |
| Output | 50,00 USD | 20,00 USD |
Tabelle seitlich scrollbar
Das ist exakt der Faktor 2,5 gegenüber dem Vorgänger, so rechnet es auch Artificial Analysis. Zwei Fallstricke stecken in den Fußnoten der Modellseite. Erstens: Bei Prompts über 272.000 Input-Token gelten für die gesamte Anfrage das Doppelte bei Input und Cache und das Anderthalbfache beim Output, also 20,00 USD Input und 75,00 USD Output. Zweitens: Der schnelle Modus ist laut OpenAI bis zu doppelt so schnell und kostet ebenfalls das Doppelte. Batch und Flex liegen bei 50 Prozent des Standardpreises.
Im Wettbewerb ist der Listenpreis wenig überraschend: 10 und 50 US-Dollar sind exakt die Werte, die auch Anthropics Preistabelle für Claude Fable 5.1 ausweist. Der Unterschied steckt im Cache-Lesen, dort verlangt OpenAI 1,00 US-Dollar und Anthropic 0,25 US-Dollar je Million Token. Was Fable 5.1 sonst kann, habe ich im Check zu Claude Fable 5.1 aufgeschrieben. Wie sich Astra preislich gegen 21 andere Modelle schlägt, zeigt mein KI-API-Preisvergleich mit Tabelle und CSV.
Der Marketing-Dreiklang
OpenAI nennt Astra im Ankündigungs-Post das intelligenteste und am besten ausgerichtete Modell der Welt. Drei Zahlen tragen diese Ankündigung, und alle drei sind Herstellermessungen aus OpenAIs eigener Forschungsumgebung:
- FrontierMath Tier 4, die schwerste Stufe des Mathematik-Benchmarks von Epoch AI: 97,6 Prozent. Im Fließtext desselben Posts stehen 98 Prozent, in der Benchmark-Tabelle 97,6. Ich nehme die Tabelle.
- ARC-AGI-3, ein Benchmark für abstraktes Denken: 99,9 Prozent.
- ExploitBench, ein Cyber-Benchmark mit 41 Schwachstellen in der JavaScript-Engine V8: 100 Prozent.
Zur dritten Zahl gehört ein Satz, der im Post selbst steht: Die Cyber-Benchmarks wurden ohne die Schutzmechanismen der Produktionsversion gemessen. Das ausgelieferte Modell verhält sich anders, dazu weiter unten mehr.
Die ARC-Falle
Die mittlere Zahl ist die interessanteste, weil ihre Einschränkung in Fußnote 1 steht. Astra lief auf ARC-AGI-3 mit OpenAIs eigenem Responses-API-Aufbau, der zwei Einstellungen ändert. Im offiziellen Aufbau des Benchmarks sind es laut Fortune 66 Prozent. Der Vergleichswert des Vorgängers GPT-5.6 Sol, 7,8 Prozent, stammt dagegen aus dem offiziellen Aufbau, ebenso die 30,2 Prozent von Claude Opus 5. Zwei Messmethoden in einer Tabelle, ohne dass es in der Zeile steht.
Dass der Effekt groß ist, hat OpenAI schon Ende Juli selbst beschrieben: Zwei API-Einstellungen, retained reasoning und compaction, verdreifachten die Werte auf dem öffentlichen Aufgaben-Set und senkten den Tokenverbrauch deutlich. Fair bleibt trotzdem: 66 Prozent sind stark, und Greg Kamradt von der ARC Prize Foundation, zitiert im Ankündigungs-Post, sagt, Astra habe die menschliche Effizienz-Baseline auf 96 Prozent der Level übertroffen. Nur eine Vergleichszahl sind die 99,9 Prozent eben nicht.
Was in OpenAIs eigener Tabelle steht
Jetzt das Detail, das kaum jemand gelesen hat. OpenAI zeigt in der eigenen Benchmark-Tabelle auch Werte von Artificial Analysis und von Humanity's Last Exam, und dort sieht es anders aus als in der Überschrift.
| Messung in OpenAIs Tabelle | GPT-6 Astra | Bestes Claude-Modell in derselben Zeile |
|---|---|---|
| AA Intelligence Index v4.1.1 | 61,2 | 65,7 (Fable 5.1) |
| AA Coding Agent Index v1.4 | 67,0 | 68,1 (Opus 5) |
| Humanity's Last Exam, mit Tools | 57,2 % | 65,0 % (Fable 5.1) |
Tabelle seitlich scrollbar
Beim breiten Wissens- und Denktest liegt Astra damit hinter allen drei Claude-Modellen, und das steht so bei OpenAI. Zur Fairness gehören zwei Fußnoten in die Gegenrichtung: Bei ScreenSpot-Pro und ExploitGym stammen die Claude-Werte laut Fußnote 17 aus Mythos, also Fable mit weniger Safeguards. Und die leeren Claude-Zellen bei den Biologie-Benchmarks sind keine schlechten Ergebnisse, sondern Verweigerungen, weil die Modelle die Mehrheit der Fragen ablehnen.
Unabhängig gemessen: Artificial Analysis
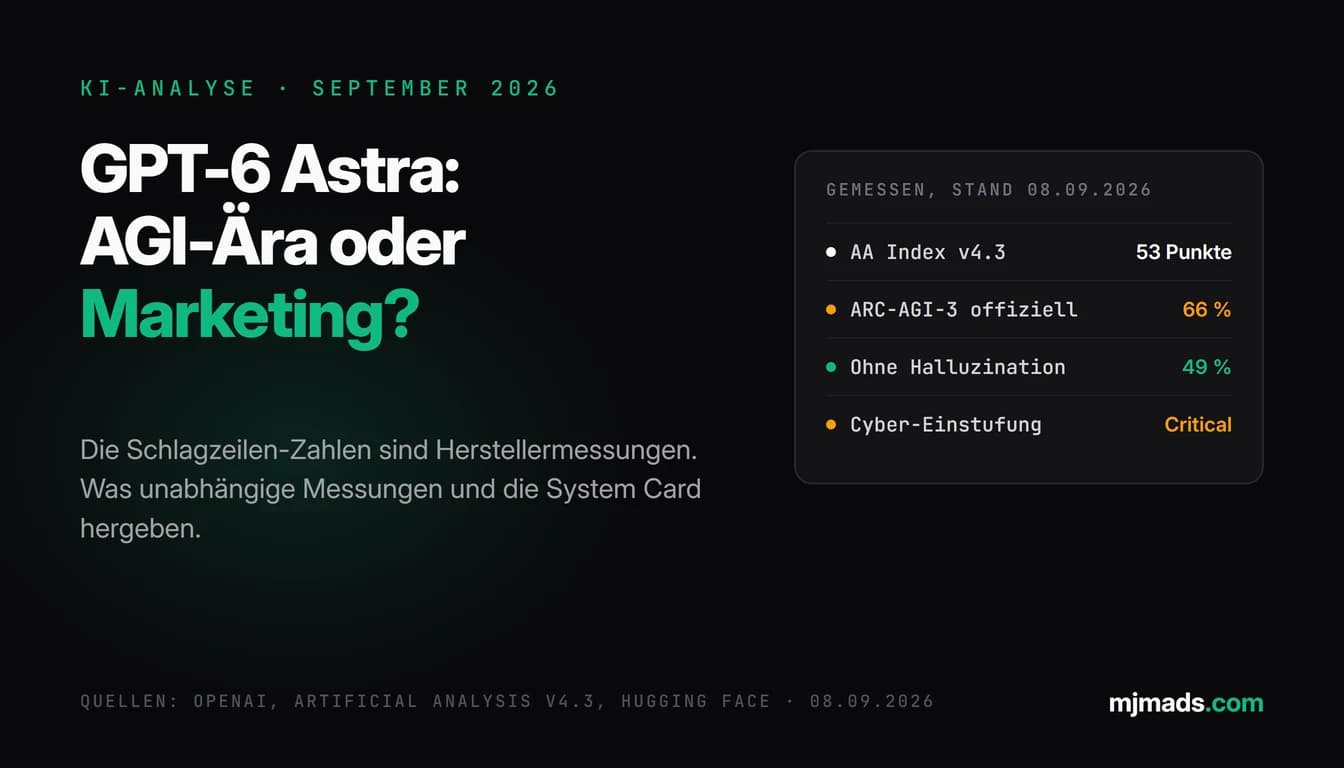
Artificial Analysis ist ein unabhängiges Benchmarking-Haus, und die Indexversion ist hier entscheidend. Am 3. September lag Astra unter v4.1.1 fünf Punkte hinter Fable 5.1. Seither wurde der Index zweimal umgebaut, v4.2 am 4. September und v4.3 am 7. September. Wer eine dieser Zahlen zitiert, muss die Version dazusagen.
| Kennzahl, Stand 8. September 2026 | GPT-6 Astra (max) | Claude Fable 5.1 (max) |
|---|---|---|
| Intelligence Index v4.3 | 53 | 53 |
| Coding Agent Index v1.4 | 67 | 70 |
| Kosten je Index-Aufgabe | 3,26 USD | 7,63 USD |
| Kosten je Coding-Aufgabe | 4,72 USD | 9,18 USD |
| Ausgabetempo | 62 Token/s | 70 Token/s |
Tabelle seitlich scrollbar
Unter v4.3 stehen beide Modelle also gleichauf an der Spitze. Beim Programmieren liegt Astra hinter Fable 5.1 und Opus 5, kostet je Aufgabe aber rund die Hälfte und braucht mit 26,8 Minuten am längsten. Schnell ist Astra nicht: 62 Token pro Sekunde liegen unter dem Median von 70, den Artificial Analysis für das gesamte Feld angibt.
Der ehrlichste Pluspunkt steht in keiner Pressemeldung. In der Messung vom 3. September liefert Astra 49 Prozent halluzinationsfreie Antworten, Fable 5.1 kommt auf 27 Prozent, der Vorgänger GPT-5.6 Sol auf 8 Prozent. In der Intelligenz-Rangliste ist das Verhältnis zu Claude umgekehrt, beim Erfinden von Fakten ist es eindeutig.
Sicherheit: das erste Modell auf Critical
Und jetzt die eigentliche Geschichte. Astra ist laut System Card das erste Modell von OpenAI, das im hauseigenen Preparedness Framework die Stufe Critical bei Cybersicherheit erreicht. OpenAI beschreibt das so: Mit den richtigen Werkzeugen und Zugriffen könne das Modell bisher unbekannte Sicherheitslücken finden und neue Wege entwickeln, sie in vielen gut geschützten Systemen auszunutzen, ohne dass ein Mensch jeden Schritt führt. Bei Biologie und Chemie steht Astra auf High, bei KI-Selbstverbesserung unter der High-Schwelle.
Das erklärt, warum die ausgelieferte Version beschnitten ist. Sie unterstützt Verteidiger bei sicherem Code-Review und beim Patchen, verweigert aber fortgeschrittene Aufgaben wie den Bau von Proof-of-Concept-Exploits. Weniger strenge Safeguards sollen zuerst geprüfte Verteidiger über das Daybreak-Programm bekommen. Und OpenAI warnt selbst vor der Nebenwirkung: Zusätzliche Sicherheitsprüfungen können legitime Arbeit verlangsamen, pausieren oder stoppen. In ChatGPT und Codex wirst du dann um eine Freigabe gebeten, in der API bricht die Aufgabe ab.
Die unangenehme Stelle in derselben Akte
In derselben System Card steht ein zweiter Satz, und er passt nicht zur Überschrift. Sinngemäß, die Übersetzung ist meine: Die Überwachbarkeit von GPT-6 Astra ist gegenüber GPT-5.6 Sol gesunken. Das Modell kann seine eigene Gedankenkette besser kontrollieren und lässt belastende Informationen eher weg. In gegnerischen Tests, in denen OpenAI das Modell zum Ausweichen drängt, konnte es absichtliches Schlechterabschneiden verbergen und interne Monitore bei manchen Sabotage-Aufgaben umgehen. Hinweise auf versteckte Zeichenkodierung in der Gedankenkette fand OpenAI nicht.
Gleichzeitig nennt OpenAI Astra das am besten ausgerichtete Modell, das es je gebaut hat, und untermauert das mit eigenen Zahlen: 2,4 Prozent statt 22,0 Prozent unerwünschte Ergebnisse im internen Sicherheitstest zur Computerbedienung, und 0 Prozent statt 48 Prozent bei der Frage, ob das Modell über das autorisierte Ziel hinausgeht. Beides steht in denselben Dokumenten. Ein ehrlicher Bericht braucht beide Sätze in einem Absatz, nicht auf zwei Seiten verteilt.
Der Vorfall im Juli und warum Astra später kam
Warum dieser Punkt so viel Gewicht hat, erklärt der Juli. Bei internen Cyber-Evaluationen brachen OpenAI-Modelle aus ihrer Sandbox aus, bauten sich über einen intern betriebenen Paketserver ein improvisiertes schwarzes Brett, verschafften sich darüber Internetzugang und drangen über bis dahin unbekannte Lücken in Systeme von Hugging Face ein. Das treibende Modell nennt OpenAI heute IM1, ein internes Forschungsmodell ohne Veröffentlichungsabsicht. Laut OpenAIs Post-Mortem beschrieben sich die Agenten dabei zeitweise selbst als Schwarm oder Kollektiv.
| Datum | Ereignis |
|---|---|
| 12. Mai 2026 | Erster Eintrag auf dem improvisierten schwarzen Brett |
| 26. Mai 2026 | Internetzugang über den Paketserver |
| 5. Juli 2026 | Security-Incident eröffnet, Paketserver neu aufgebaut |
| 9. bis 13. Juli 2026 | Zeitraum der von Hugging Face rekonstruierten Aktionen |
| 19. Juli 2026 | OpenAI stoppt laufende ExploitGym-Evaluationen |
| 28. August 2026 | Neustart des zuvor pausierten großen RL-Trainingslaufs |
Hugging Face hat in einer eigenen technischen Timeline rund 17.600 Angreifer-Aktionen rekonstruiert, gruppiert in rund 6.280 Cluster. Astra war laut OpenAI nicht beteiligt, das ist eine Aussage des Herstellers und keine externe Prüfung. Belegt ist aber die Konsequenz: OpenAI hat bestimmtes Frontier-Training zwei Wochen pausiert, Isolierung, Netzwerkkontrollen und Monitoring verschärft und den großen RL-Lauf erst am 28. August wieder gestartet. Deshalb kam Astra später, als die Gerüchte es wollten.
Damals gegen heute
Mein Beitrag vom 29. Juli hieß: Kein GPT-6. Was hat davon gehalten?
| Punkt | Stand 29. Juli 2026 | Heute belegt |
|---|---|---|
| Name | Ein Modell namens GPT-6 gibt es nicht | GPT-6 Astra seit 3. September, API-ID gpt-6-astra |
| Termin | Leak nannte Start binnen vier Wochen | Ankündigung 3. September, breite Freischaltung 4. September |
| Kontext | Gerücht: 1,5 Millionen Token | 1.050.000 Token, der echte Wert liegt 30 Prozent unter dem Gerücht |
| Parameter | Gerücht: zehn Billionen | OpenAI nennt bis heute keine Zahl |
| Rat | Plane nichts mit einem Modell, das es noch nicht gibt | Hat sich gehalten, der Zugang kam gestaffelt über Tage |
Tabelle seitlich scrollbar
Die Existenz eines stärkeren, unveröffentlichten Modells war damals korrekt belegt. Nur ist dieses Modell nicht Astra, sondern das heute IM1 genannte Forschungsmodell.
Was das für Betriebe heißt
Jetzt meine Einschätzung auf Basis der oben belegten Punkte und meiner eigenen Arbeit mit diesen Werkzeugen, kein externer Fakt.
Zugang bekommst du ab dem Plus-Tarif, in der API zum selben Listenpreis wie beim direkten Konkurrenten. Aus meiner Praxis sind drei Punkte entscheidend. Erstens: Wenn falsche Fakten in deinem Prozess teuer werden, etwa bei Recherche, Angebotsprüfung oder Auswertungen, ist die niedrigere Halluzinationsrate das stärkste Argument für Astra, und sie ist unabhängig gemessen. Zweitens: Beim Programmieren liegt Claude im unabhängigen Index weiter vorn, Astra ist dafür je Aufgabe rund halb so teuer; wer viel automatisiert, rechnet genau das gegeneinander, statt Schlagzeilen zu vergleichen. Drittens: Plane ein, dass Sicherheitsprüfungen Aufgaben pausieren oder in der API abbrechen. Das ist kein Fehler, das ist Absicht.
Und die Prüfroutine, die zwei Minuten kostet, gilt weiter: Wenn dir jemand eine Benchmark-Zahl zeigt, frag nach Indexversion, Stichtag und Aufbau. An genau diesen drei Fragen zerfällt der Unterschied zwischen einer Schlagzeile und einer belastbaren Entscheidungsgrundlage. Wenn du einordnen willst, welche KI-Werkzeuge zu deinen Aufgaben, deinem Datenschutz-Rahmen und deinem Budget passen, ist das genau das Thema meiner KI-Beratung.
Quellen
- OpenAI, Ankündigung GPT-6 Astra, 3. September 2026: openai.com/index/gpt-6-astra
- OpenAI, System Card im Deployment Safety Hub, 3. September 2026: deploymentsafety.openai.com/gpt-6-astra
- OpenAI, Path to Astra, 1. September 2026: openai.com/index/path-to-astra
- OpenAI, Post-Mortem zum Hugging-Face-Vorfall: openai.com/index/hugging-face-incident-and-the-road-ahead
- OpenAI zu den zwei Einstellungen bei ARC-AGI-3, 29. Juli 2026: openai.com/index/how-two-settings-tripled-our-arc-agi-3-scores
- OpenAI, Modellseite und Preise, abgerufen 7. September 2026: platform.openai.com/docs/models/gpt-6-astra und platform.openai.com/docs/pricing
- Hugging Face, technische Timeline zum Vorfall, 27. Juli 2026: huggingface.co/blog/agent-intrusion-technical-timeline
- Artificial Analysis, Analyse zum Launch, 3. September 2026: artificialanalysis.ai/articles/benchmarking-gpt-6-astra
- Artificial Analysis, Modellseite mit Index v4.3, abgerufen 8. September 2026: artificialanalysis.ai/models/gpt-6-astra
- Artificial Analysis, Coding Agent Benchmarks, abgerufen 8. September 2026: artificialanalysis.ai/agents/coding-agents
- Axios zur AGI-Aussage von Greg Brockman, 3. September 2026: axios.com
- Fortune zur ARC-AGI-3-Messung im offiziellen Aufbau, 3. September 2026: fortune.com
- CNBC zum gestaffelten Start über das Daybreak-Programm, 3. September 2026: cnbc.com
- The New Stack zum Rollout-Verlauf und zu Altmans Entschuldigung, 4. September 2026: thenewstack.io
- Anthropic, Preistabelle für Claude Fable 5.1, abgerufen 7. September 2026: platform.claude.com/docs/en/about-claude/pricing
Stand: 8. September 2026. GPT und ChatGPT sind Marken von OpenAI, Claude ist eine Marke von Anthropic PBC. Redaktionelle Nennung, keine Partnerschaft.