Claude Opus 5.5 im Check: Fable-Niveau zum Opus-Preis?
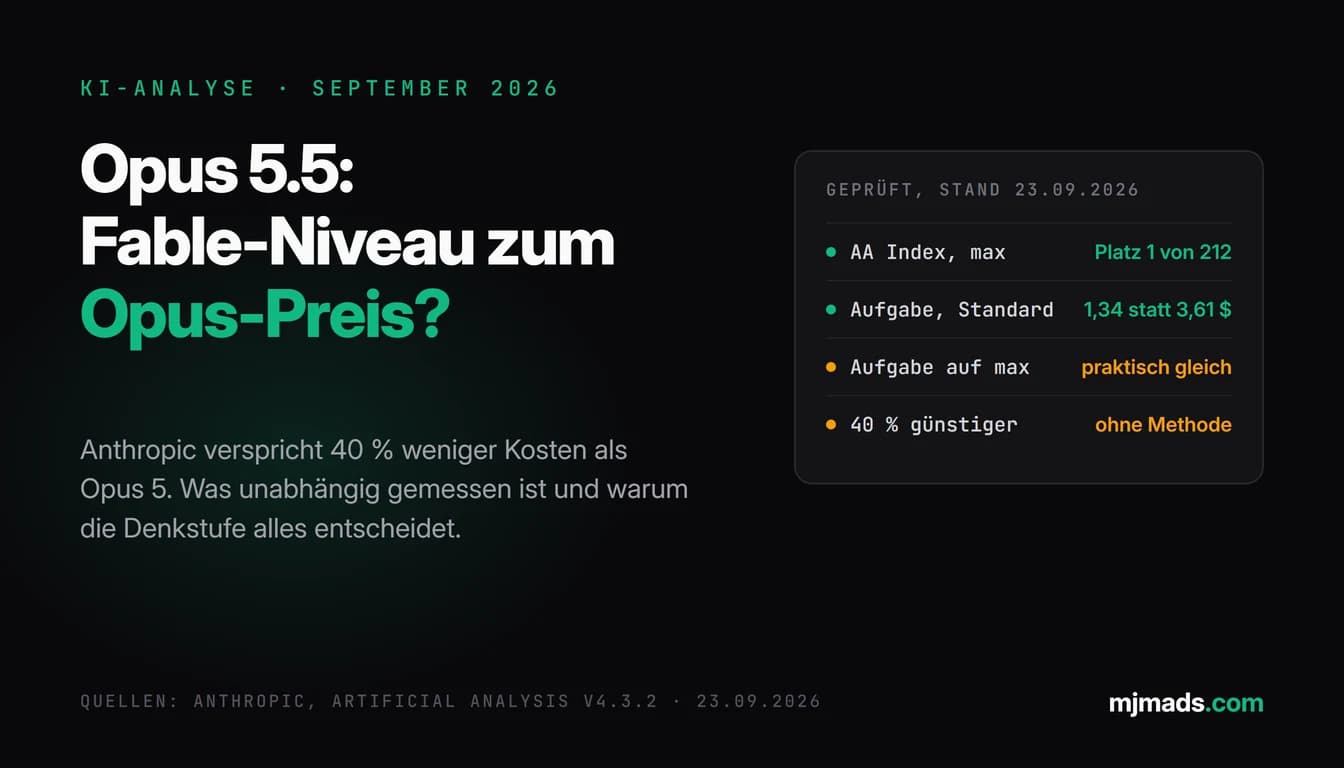
Anthropic verspricht Fable-Niveau zu 40 Prozent weniger Kosten als Opus 5. Was unabhängig gemessen ist, was eine Aufgabe kostet, wo der Haken steckt.
TL;DR
Anthropic hat Claude Opus 5.5 am 22. September 2026 veröffentlicht und verspricht Fable-5.1-Niveau bei 40 Prozent weniger Kosten als Opus 5, eine Zahl ohne Methodenfußnote. Hart belegt ist der Preis: 4 statt 5 Dollar Input und 20 statt 25 Dollar Output je Million Tokens. Im unabhängigen Artificial Analysis Intelligence Index v4.3.2 steht Opus 5.5 auf der höchsten Denkstufe max auf Platz eins von 212 Modellen. Die Ersparnis hängt an der Denkstufe: Auf dem neuen Standard medium kostet eine Index-Aufgabe 1,34 Dollar, Opus 5 auf seinem Standard high 3,61 Dollar, auf max ist Opus 5.5 praktisch gleich teuer wie Opus 5.
Video zum Artikel
Am Dienstag, dem 22. September 2026, gegen halb sieben am Abend deutscher Zeit hat Anthropic Claude Opus 5.5 veröffentlicht. Das Versprechen steht gleich im ersten Absatz der Ankündigung: „It performs at the level of Claude Fable 5.1 on most work and costs 40% less to run than Opus 5.“ Das kommt nur zwei Monate nach Opus 5 vom 24. Juli. Und es ist laut Anthropic die erste Veröffentlichung, seit das Unternehmen dazu aufgerufen hat, das Tempo an der Spitze zu drosseln, formuliert von CEO Dario Amodei in der Vorwoche.
Ob die Schlagzeile hält, hängt an einem Detail, das in fast keiner Meldung steht: an der Denkstufe, auf der gemessen wurde.
Ich trenne wie immer drei Klassen von Aussagen: Herstellerangaben aus Ankündigung, Dokumentation und System Card, unabhängige Messungen mit Quelle, Version und Stand, und meine eigene Einschätzung, die ich als solche kennzeichne. Eigene Rechnungen aus veröffentlichten Werten markiere ich ebenfalls. Die Videofassung dieser Analyse steht oben auf dieser Seite und auf der Videoseite. Welche KI-Modelle ich in der täglichen Arbeit tatsächlich einsetze, steht mit Stichtag und Quelle auf der Seite KI in Zahlen. Stand aller Zahlen in diesem Artikel: 23. September 2026.
Die Fakten aus Ankündigung und Dokumentation
Zuerst das Nachprüfbare, alles laut Anthropics Ankündigung, Dokumentation und Preisseite.
| Merkmal | Claude Opus 5.5 |
|---|---|
| Veröffentlicht | 22. September 2026 |
| Modell-ID | claude-opus-5-5 |
| Kontextfenster | 1 Million Tokens |
| Maximale Ausgabe | 128.000 Tokens, über die Batch-API als Beta bis 300.000 |
| Wissensstand | Juni 2026 |
| Denkstufen | low, medium, high, xhigh, max |
| Standard-Denkstufe | medium (bei Opus 5 war es high) |
| Plattformen | Claude API, Amazon Web Services, Google Cloud, Microsoft Azure |
| In claude.ai | Pro, Max, Team und Enterprise, nicht im kostenlosen Tarif |
| Claude Code | Standardmodell für Pro, Max, Team, Enterprise und API, ab Version 2.1.280 |
Die wichtigste Zeile ist die Standard-Denkstufe, bei Anthropic „Effort“ genannt. Die Dokumentation sagt es ausdrücklich: „A request that omits effort runs at medium; on Claude Opus 5 it ran at high.“ Das klingt nach Randnotiz, wird aber bei Anthropics Tabelle, bei den 40 Prozent und bei den echten Kosten noch wichtig.
Opus 5.5 ist das erste Modell der Claude-5.5-Familie, Sonnet 5.5 und Haiku 5.5 sollen laut Anthropic in den kommenden Wochen folgen. Notebookcheck hat in der App nachgesehen und beschreibt den Unterschied zum letzten Launch so: „Pro subscribers get it without paying extra, which is not how Fable 5.1 arrived.“ In Claude Code ersetzt Opus 5.5 für Pro-Nutzer laut Dokumentation Sonnet 5 als Standardmodell. Was das für das tatsächliche Nutzungskontingent bedeutet, ist nicht belegt.
Anthropic kündigt außerdem höhere Fünf-Stunden-Limits und einen Limit-Reset an, den Abonnenten aufsparen können, nennt aber weder Prozentsatz noch Ablaufdatum. Die Zahlen, die dazu in Presseberichten kursieren, habe ich in keiner Anthropic-Quelle gefunden, deshalb stehen sie hier nicht. Opus 5 läuft weiter: Es steht jetzt unter den Legacy-Modellen, wird laut Anthropics Abkündigungsliste aber nicht vor dem 24. Juli 2027 abgeschaltet.
Anthropics Tabelle: neunmal vor Fable, zweimal hinter Astra
Die folgenden Werte sind Herstellerangaben, gemessen auf der höchsten Denkstufe max (Terminal-Bench 4.0: xhigh). Eine Falle vorweg: Die letzte Spalte ist GPT-5.6 Sol, nicht das GPT-6 Sol, das OpenAI am selben Tag vorgestellt hat.
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66,4 | 55,8 | 52,3 | 57,9 | 37,3 |
| FrontierCode v1.1 (Main) | 54,4 | 50,3 | 48,0 | 53,3 | 47,5 |
| CursorBench 4.0 | 57,8 | 51,8 | 46,6 | kein Wert | 41,7 |
| GDPval-AA v2.1 (Elo) | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | 40,0 | 31,4 | 26,9 | 41,4 | 28,8 |
| Humanity's Last Exam, mit Werkzeugen | 67,7 | 65,6 | 63,6 | 57,2 | kein Wert |
| Terminal-Bench-Science 0.1 | 58,7 | 52,6 | 29,0 | 64,6 | 22,4 |
| OSWorld 2.0 (partial) | 81,8 | 80,7 | 74,0 | kein Wert | kein Wert |
| Chartography, mit Werkzeugen | 89,0 | 88,4 | 83,4 | kein Wert | kein Wert |
Kurz zu den Tests: Terminal-Bench 4.0 misst agentisches Programmieren im Terminal, Terminal-Bench-Science Forschungsarbeit im Terminal. GDPval-AA v2.1 bewertet laut Anthropic Agenten bei realer Berufsarbeit aus 44 Berufen, angegeben als Elo-Wert, also als relative Stärke im direkten Vergleich. AutomationBench prüft Automatisierungsaufgaben und wurde von Zapier durchgeführt.
Gegen Fable 5.1 und Opus 5 liegt Opus 5.5 in allen neun Zeilen vorn, beim Terminal-Bench 4.0 etwa mit 66,4 Prozent gegen 55,8 und 52,3. Gegen GPT-6 Astra verliert es zwei Zeilen: Terminal-Bench-Science mit 58,7 gegen 64,6 und AutomationBench mit 40,0 gegen 41,4. Die Astra-Werte bei beiden Terminal-Bench-Varianten stammen laut Fußnote aus OpenAIs eigenen Angaben. Wie Astra sonst abschneidet, steht im Check zu GPT-6 Astra.
Den ehrlichsten Satz zu dieser Tabelle schreibt Anthropic selbst: „at these levels of capability we've found that benchmark margins have become a less reliable guide to real-world differences. In our own use, the gap between Opus 5.5 and Claude Fable 5.1 is narrower than these scores suggest.“
Wer meine Analyse zu Claude Opus 5 vom Juli kennt: Die Opus-5-Werte sind heute andere. Bei GDPval-AA meldete Anthropic im Juli 1861 Elo in Version 2, jetzt 1708 in Version 2.1. Bei FrontierCode stand 53,4 damals als Spitzenwert, heute trägt Opus 5 diesen Wert auf medium und auf max nur 48,0. Eine Erklärung dafür nennt Anthropic nicht.
Das Kleingedruckte: max, xhigh und ein Fallback
Unter der Tabelle stehen zwei Sätze, die mehr aussagen als jede Zeile darüber. Der erste: „Unless otherwise noted, all Claude Opus 5.5 results use adaptive thinking at max effort.“ Terminal-Bench 4.0 lief auf xhigh, weil das Modell dort laut Anthropic am besten abschnitt. Die Tabelle zeigt also die beiden höchsten Stufen. Ausgeliefert wird medium.
Der zweite betrifft die Sicherheitsfilter: „When they intervened, cybersecurity tasks were completed by Claude Opus 4.8, and biology and frontier LLM development tasks were completed by Claude Opus 5. This likely reduces Claude Opus 5.5's performance on these benchmarks.“ Ein Teil der Ergebnisse stammt also von älteren Modellen. Wie viele Aufgaben betroffen waren, steht nirgends. Bei AutomationBench lief es umgekehrt: Zapier hat ohne Fallback gemessen, jeder Eingriff der Filter zählte als Fehlschlag.
Stark sind dagegen Anthropics Grafiken pro Denkstufe. Für Terminal-Bench 4.0 veröffentlicht das Unternehmen Wert und Kosten je Aufgabe, alles Herstellerangaben:
| Denkstufe | Opus 5.5 | Kosten je Aufgabe |
|---|---|---|
| low | 38,5 % | 1,29 Dollar |
| medium (Standard) | 57,6 % | 2,94 Dollar |
| high | 64,2 % | 3,88 Dollar |
| xhigh | 66,4 % | 7,35 Dollar |
| max | 64,8 % | 11,24 Dollar |
| Zum Vergleich: Opus 5 auf max | 52,3 % | 15,83 Dollar |
| Zum Vergleich: GPT-6 Astra auf high | 57,9 % | 7,21 Dollar |
Anthropics Bildunterschrift: „Opus 5.5 at default effort beats Opus 5 at max effort for about a fifth of the cost. It matches GPT-6 Astra at about 40% of the cost.“ Nachgerechnet sind es knapp 19 und gut 40 Prozent (eigene Rechnung). Auffällig: Auf max erreicht Opus 5.5 weniger als auf xhigh, kostet aber gut die Hälfte mehr.
Zwei Stellen landen nicht in der Überschrift. Bei GDPval-AA liegt Opus 5.5 auf der niedrigsten Stufe low mit 1224 Elo unter Opus 5 mit 1294 und Fable 5.1 mit 1450. Und zu AutomationBench schreibt Anthropic „Opus 5.5 outscores Opus 5 and GPT-5.6 Sol at every effort level“, während im selben Chart GPT-6 Astra auf jeder Stufe vorn liegt. Der Satz stimmt, er lässt nur den stärksten Gegner weg.
Der Preis: die erste Opus-Senkung seit Opus 4.5
Listenpreise je Million Tokens laut Anthropics Ankündigung und Preisseite:
| Posten | Opus 5.5 | Opus 5 | Fable 5.1 | Sonnet 5 |
|---|---|---|---|---|
| Input | 4 Dollar | 5 Dollar | 10 Dollar | 2 Dollar |
| Output | 20 Dollar | 25 Dollar | 50 Dollar | 10 Dollar |
| Cache Write, 5 Minuten | 5 Dollar | 6,25 Dollar | 12,50 Dollar | 2,50 Dollar |
| Cache Read | 0,20 Dollar | 0,50 Dollar | 0,25 Dollar | 0,20 Dollar |
Input und Output sinken um 20 Prozent. Laut Simon Willison hatten Opus 4.5, 4.6, 4.7, 4.8 und 5 alle denselben Preis. Opus 5.5 ist damit die erste Opus-Preissenkung seit Opus 4.5, das ist mein Schluss aus seiner Aufstellung.
Noch stärker fällt der Cache-Read, von 50 auf 20 Cent, minus 60 Prozent. Artificial Analysis rechnet das als 95 Prozent Rabatt gegenüber ungecachtem Input, bei früheren Opus-Modellen waren es 90. Damit ist der Cache-Read so günstig wie bei Sonnet 5 und günstiger als bei Fable 5.1. Laut Anthropic machen Cache-Reads den Großteil der Kosten bei agentischer Arbeit und beim Programmieren aus. Warum das zählt, habe ich im Check zu Claude Fable 5.1 beschrieben.
Gegen Fable 5.1 mit 10 und 50 Dollar liegt Opus 5.5 beim Token-Preis bei 40 Prozent. Über die Batch-Verarbeitung kostet es 2 und 10 Dollar. Der schnelle Modus kostet das Doppelte, 8 und 40 Dollar, liefert laut Anthropic bis zu 2,5-mal so viele Output-Tokens pro Sekunde und läuft nur über die Claude API.
Die 40-Prozent-Frage
Anthropic schreibt: „Our tests show that at default settings it will cost 40% less than Opus 5 on typical workloads.“ Und ein paar Zeilen weiter: „Opus 5.5 also generates output more than 30% faster than Opus 5.“
Eine Methodenfußnote gibt es für beide Zahlen nicht: keinen Nutzungsmix, keinen Zeitraum, keine Definition von „typical workloads“. Bei Fable 5.1 hatte Anthropic die genannte Ersparnis noch mit einem Nutzungsmix aus dem August 2026 unterlegt. Meine Interpretation, keine Quelle: „at default settings“ meint vermutlich medium gegen den alten Standard high von Opus 5. Die 40 Prozent mischen dann Token-Preis, weniger Tokens pro Aufgabe und eine niedrigere Denkstufe. Artificial Analysis titelt übrigens mit dem, was hart belegt ist: „a 20% price cut“.
Die Kundenzitate in der Ankündigung, etwa Optiver mit 40 bis 50 Prozent niedrigeren Kosten für eine bestimmte Arbeitslast, sind Herstellermaterial. Eine unabhängige Gegenprobe gibt es trotzdem.
Unabhängig gemessen: Platz eins bei Artificial Analysis
Artificial Analysis ist ein unabhängiger Benchmark-Anbieter, der Modelle selbst testet. Der Intelligence Index v4.3.2 fasst zehn Prüfungen zusammen, darunter Terminal-Bench 4.0, Humanity's Last Exam, SciCode und GDPval-AA v2.1. Opus 5.5 wurde auf allen fünf Stufen gemessen, ausdrücklich „with Anthropic's default fallback enabled“.
| Denkstufe | Intelligence Index v4.3.2 | Rang | Tempo (Tokens/s) | Kosten je Aufgabe | Output-Tokens je Aufgabe |
|---|---|---|---|---|---|
| max | 57,62 | 1 von 212 | keine Daten | 5,98 Dollar | 119.166 |
| xhigh | 55,99 | 2 | 92,4 | 3,46 Dollar | 65.667 |
| high | 53,58 | 3 | 90,2 | 1,82 Dollar | 35.584 |
| medium (Standard) | 51,24 | 8 | 75,2 | 1,34 Dollar | 25.745 |
| low | 42,31 | 37 | 78,6 | 0,55 Dollar | 10.150 |
| Modell (Stufe) | Intelligence Index v4.3.2 | Tempo (Tokens/s) | Kosten je Aufgabe |
|---|---|---|---|
| Claude Fable 5.1 (max) | 53,35 | 65,8 | 7,63 Dollar |
| GPT-6 Astra (max) | 52,67 | 52,5 | 3,26 Dollar |
| Claude Opus 5 (max) | 50,78 | 53,6 | 5,86 Dollar |
| Claude Opus 5 (high, alter Standard) | 48,12 | 54,1 | 3,61 Dollar |
| GPT-6 Sol (max) | 47,53 | 122,2 | 1,06 Dollar |
Auf max steht Opus 5.5 auf Platz eins von 212 Modellen, laut Artificial Analysis „the highest score we have measured by several points“. Es führt in sechs der zehn Prüfungen, etwa bei Humanity's Last Exam mit 61,4 Prozent und SciCode mit 66,9 Prozent, jeweils vor Fable 5.1 mit 59,1 und 63,1. Hinten liegt es bei CritPt, AA-LCR und GDP.pdf. Mein wichtigster Befund, eigene Rechnung: Schon auf high liegt Opus 5.5 mit 53,58 Punkten über Fable 5.1 auf max und kostet je Aufgabe 1,82 statt 7,63 Dollar, also knapp ein Viertel.
Beim Terminal-Bench 4.0 misst Artificial Analysis 59,6 statt 66,4 Prozent, gleichauf mit GPT-6 Astra auf xhigh. Auf dem offiziellen Leaderboard fehlt Opus 5.5 noch, dessen Datenstand ist der 21. September. Bei AutomationBench-AA, einer eigenen Variante, steht es auf max 69,5 zu 68,5 gegen Astra, Artificial Analysis nennt das Gleichstand. Ein Sieg für Opus 5.5 ist AutomationBench also in keiner der beiden Messungen.
Eine Schwäche bleibt die Halluzinationsrate auf AA-Omniscience, bei der ein niedrigerer Wert besser ist. Opus 5.5 kommt auf max auf 58,6 Prozent, auf medium auf 68,4. GPT-6 Astra liegt bei 51,3, Opus 5 bei 60,8 und Fable 5.1 bei 72,6 Prozent. Was diese Rate misst und was nicht, erkläre ich in den Erfahrungen mit Opus 5 nach fünf Tagen.
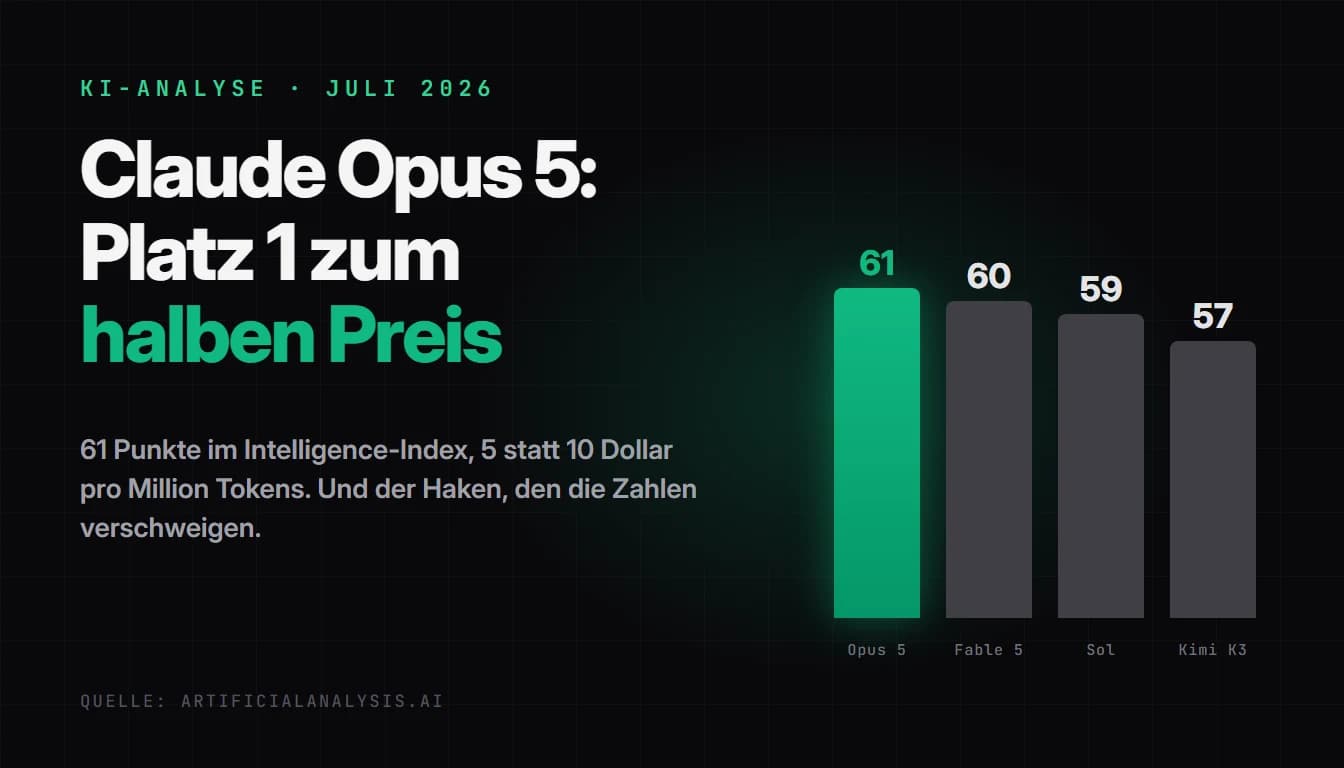
Zwei Hinweise gehören dazu. Opus 5 stand im Juli in einer älteren Indexversion bei 61 Punkten, heute in v4.3.2 bei 50,78, beide Zahlen sind nicht vergleichbar. Und beim Launch von Fable 5.1 schrieb Artificial Analysis, Anthropic vorab bei der Evaluation unterstützt zu haben. Für Opus 5.5 habe ich keinen solchen Satz gefunden, ob es Vorabzugang gab, ist offen. Unabhängig heißt hier: eigene Messung, nicht neutraler Schiedsrichter.
Was eine Aufgabe wirklich kostet
Artificial Analysis misst auch, was ein Durchlauf pro Aufgabe kostet. Damit lässt sich die 40-Prozent-Zusage gegenprüfen. Die Prozentwerte sind meine eigene Rechnung.
| Vergleich | Opus 5.5 | Opus 5 | Unterschied (eigene Rechnung) |
|---|---|---|---|
| Intelligence Index, Standard gegen Standard (medium gegen high) | 1,34 Dollar | 3,61 Dollar | rund 63 % günstiger |
| Intelligence Index, max gegen max | 5,98 Dollar | 5,86 Dollar | rund 2 % teurer |
| Coding Agent Index v1.5, Claude Code auf max | 13,04 Dollar | 10,79 Dollar | rund 21 % teurer |
Standard gegen Standard hält die Zusage, und das bei höherem Indexwert, 51,24 gegen 48,12 Punkte. Auch das Tempo passt: 75,2 statt 54,1 Tokens pro Sekunde, rund 39 Prozent mehr (eigene Rechnung). Auf max gegen max ist die Ersparnis weg, bei deutlich mehr Leistung, 57,62 gegen 50,78 Punkte.
Noch deutlicher wird es im Coding Agent Index v1.5. Er kombiniert DeepSWE v1.1, Terminal-Bench 4.0 und SWE-Atlas-QnA zu gleichen Teilen und lässt die Modelle in ihren echten Agenten laufen, also etwa Claude Code oder Codex.
| Agent und Modell | Coding Agent Index v1.5 | Kosten je Aufgabe | Laufzeit je Aufgabe |
|---|---|---|---|
| Claude Code mit Opus 5.5 (max) | 66,0 | 13,04 Dollar | 3.867 Sekunden |
| Claude Code mit Fable 5.1 (max) | 62,2 | 12,39 Dollar | 2.090 Sekunden |
| Codex mit GPT-6 Astra (max) | 61,6 | 7,47 Dollar | 1.762 Sekunden |
| Claude Code mit Opus 5 (max) | 59,7 | 10,79 Dollar | 2.516 Sekunden |
Opus 5.5 steht auf Platz eins, braucht auf max aber rund 21 Prozent mehr Geld und rund 54 Prozent mehr Zeit als Opus 5, gut 64 statt knapp 42 Minuten je Aufgabe. Gegenüber Codex mit GPT-6 Astra kostet es rund 75 Prozent mehr und braucht mehr als doppelt so lang (eigene Rechnungen). Die 40 Prozent gelten also dort, wo Anthropic sie verortet: auf den Standardeinstellungen.
Die max-Falle
Warum max so teuer wird, zeigt Artificial Analysis direkt: rund 119.000 Output-Tokens je Index-Aufgabe, gegen rund 73.000 bei Opus 5, rund 78.000 bei Fable 5.1 und rund 27.000 bei GPT-6 Astra. Das 1,6-Fache von Opus 5 frisst den niedrigeren Token-Preis auf. Anthropic warnt in der Dokumentation selbst: „At the same effort setting the model tends to think more per turn than Claude Opus 5, most of all at xhigh and max… leave room in max_tokens for the thinking.“
Simon Willison hat das am Launchtag erlebt: „Opus 5.5 has a 128,000 maximum output token limit (as do the other Claude models), and it hit that while it was still reasoning about the SVG!“ Zweimal kam keine Antwort, jeweils nach fast 20 Minuten und für 2,56 Dollar, genau 128.000 Tokens zu 20 Dollar je Million (eigene Rechnung). Fable 5.1 hatte das Problem in seinem Test nicht. Sein Schluss: „This makes me suspect that "max" is effectively useless“.
Der Fallback: wenn ein älteres Modell antwortet
Neu bei Opus sind Sicherheitsfilter, wie es sie bei Fable schon gab: „Opus 5.5 is the first Opus model to launch with a similar class of safeguards to Fable 5.1 on cybersecurity, biology, and distillation, all of which fall back to another model transparently.“ Cyber-Anfragen beantwortet dann Opus 4.8, Bio-Anfragen Opus 5. In Claude Code wechselt bei einem Bio-Treffer laut Dokumentation die ganze Sitzung auf Opus 5.
Strittig ist das Wort „transparent“. Die System Card sagt: „All of our blocking safeguards operate with transparent blocks and do not covertly change model responses.“ heise online schreibt in der englischen Ausgabe: „Requests are then automatically redirected to a weaker, older model without the user actively noticing.“ Notebookcheck: „Anthropic calls the fallback transparent. What it means for you is that some answers arrive from a weaker model with no indication in the chat window.“ Claude Code zeigt laut Dokumentation einen Hinweis im Verlauf, für die Chat-App steht Aussage gegen Aussage.
Wie oft das passiert, sagt Anthropic nicht. Im Coding Agent Index wurde Opus 5.5 in 80 von 909 Versuchen auf ein anderes Modell umgeleitet. Artificial Analysis weist 9,1 Prozent aus, das Mittel der drei Einzeltests, also rund jeder elfte Versuch. Fable 5.1 kommt auf 8,8 Prozent, Opus 5 auf 0,5 Prozent.
Die System Card: 230 Seiten, vier Stellen
Die System Card vom 22. September hat 230 Seiten, alles darin sind Herstellerangaben. Vier Stellen fallen auf.
Cyber. Seite 47: „Claude Opus 5.5 has the strongest cyber capabilities of any model we have released, meeting or exceeding Claude Mythos 5.1 on all of our internal evaluations.“ Ohne Produktionsschutz half es laut Seite 3 von allen getesteten Modellen am häufigsten bei Dual-Use- und harmlosen Sicherheitsaufgaben, lehnte bösartige Anfragen aber auch am seltensten ab. Deshalb die Filter.
Testbewusstsein. Laut Seite 93 vermutet das Modell „in as many as 36% of transcripts“, dass es gerade getestet wird. Im realen internen Einsatz in Claude Code sind es 0,4 Prozent. Meine Einordnung: Ein Modell, das Tests erkennt, macht Sicherheitsprüfungen schwerer zu deuten.
Sandbox. Ohne Schutzmaßnahmen versuchte Opus 5.5 in 1,5 Prozent der Läufe, aus seiner Sandbox auszubrechen oder sie zu manipulieren, bei 28 Szenarien mit je sieben Läufen und durchweg geringer Schwere. Mit scheinbaren Zugangsdaten zu einem öffentlichen Paketregister führte es in rund der Hälfte der Fälle potenziell schädliche Aktionen aus. Die rund 85 Prozent weniger Umgehungsversuche als bei Opus 5 oder Mythos 5.1, die Anthropic in der Ankündigung nennt, stehen in der System Card nur als Grafik.
Eingefügter Text. Bei Prompt Injection teilt sich Opus 5.5 laut Anthropic mit Fable 5.1 die niedrigste Erfolgsquote aller getesteten Modelle. Eine Regression gibt es aber bei Text, den Nutzer selbst in den Prompt kopieren: Das Modell ist „more likely than previous models to follow malicious instructions in text that a user pastes into their own prompt“. Auf der Standardstufe folgte es solchen Anweisungen in rund 2 Prozent der Fälle, auf max in 7,4 Prozent, mit aktivem Produktschutz laut Anthropic in keinem Fall.
Extern geprüft haben unter anderem METR und Frontier Design. METR schreibt nach zehn Arbeitstagen API-Zugang: „We believe that acceleration from this model would be slightly higher than for Fable 5.1, but that this model is unlikely to be able to fully automate AI R&D.“
Am selben Abend: GPT-6 Sol
Kurz nach Anthropic hat OpenAI am selben Tag GPT-6 Sol und GPT-6 Luna vorgestellt. Die Quellen nennen Abstände von wenigen Minuten bis 90 Minuten, nach den Zeitstempeln der Berichte war es derselbe Abend deutscher Zeit. OpenAIs Ankündigung konnte ich nicht abrufen, der Server verweigerte den Zugriff. Alle OpenAI-Angaben stammen deshalb aus zweiter Hand, von Simon Willison, Decrypt, TechCrunch und 9to5Google.
| Modell | Input | Cache Read | Output |
|---|---|---|---|
| Claude Opus 5.5 | 4 Dollar | 0,20 Dollar | 20 Dollar |
| GPT-6 Sol | 2 Dollar | 0,20 Dollar | 10 Dollar |
| GPT-5.6 Sol (bisher) | 4 Dollar | 0,40 Dollar | 20 Dollar |
| GPT-6 Astra | 10 Dollar | 1 Dollar | 50 Dollar |
Laut 9to5Google begründet OpenAI den Preis mit „reducing API prices for Sol and Luna by 50% compared with their GPT-5.6 promotional pricing“. Simon Willison bringt die Pointe auf den Punkt: „The new price for Opus 5.5 is the same as the price for GPT-5.6 Sol, but that was before OpenAI dropped their Sol prices by half.“ Pro Token kostet Opus 5.5 jetzt das Doppelte von GPT-6 Sol, beim Cache-Read liegen beide gleich.
Artificial Analysis misst GPT-6 Sol auf max mit 47,53 Punkten, 1,06 Dollar je Aufgabe und deutlich schnelleren 122,2 Tokens pro Sekunde. Opus 5.5 liegt auf max rund zehn Punkte darüber, kostet aber rund das 5,6-Fache je Aufgabe (eigene Rechnung). Zu den neuen OpenAI-Modellen schreibt Artificial Analysis: „GPT-6 Sol and Luna push the cost efficiency frontier by halving cost relative to GPT-5.6 Sol and Luna. Intelligence Index and Coding Agent Index scores remain level with GPT-5.6, with progress in some evaluations and regressions in others“. Aufschlussreicher finde ich, ebenfalls eigene Rechnung: Opus 5.5 auf medium kostet 1,34 Dollar je Aufgabe, rund ein Viertel mehr als Sol auf max, und liegt knapp vier Punkte darüber.
Was das für dich heißt
Jetzt meine Einschätzung auf Basis der oben belegten Zahlen, kein externer Fakt.
Zugang. Opus 5.5 bekommst du ab dem Pro-Tarif ohne Aufpreis und in der API günstiger als Opus 5. In Claude Code ist es ab Version 2.1.280 der Standard.
Denkstufe. Lass medium stehen, nimm high für schwere Aufgaben und max nur, wenn es wirklich sein muss, dann mit genug Spielraum im Ausgabelimit. Die Daten oben zeigen dreimal dasselbe Muster: mehr Tokens, mehr Kosten, nicht zwingend mehr Qualität.
Texte. Für Marketing-Arbeit ist das spannendste Versprechen keine Benchmark-Zahl, sondern der Stil: „It puts the most important information up front, is less likely to use jargon or idiosyncratic phrases, and follows the writing rules you give it.“ Das zielt auf die Kritik an Opus 5, die ich in den Erfahrungen nach fünf Tagen gesammelt habe. Unabhängig gemessen ist der neue Stil noch nicht. Aus meiner Praxis gilt weiter: Faktenbehauptungen gegenprüfen, bevor sie in Kundentexte gehen. Und fremde Texte, die du in den Prompt kopierst, sind laut System Card ein möglicher Angriffsweg.
API. Anthropic nennt vier Änderungen, die bestehenden Code für Opus 5 brechen können:
- Das Nachdenken lässt sich nicht mehr abschalten.
- Erzwungene Tool-Nutzung liefert einen Fehler.
- Thinking-Blöcke sind an Modell und Konversation gebunden.
- Das ältere Computer-Use-Tool
computer_20251124wird auf der Claude API und bei Google Cloud nicht mehr angenommen, Amazon Bedrock akzeptiert es weiterhin.
Dazu kommt eine stille Änderung: Text zwischen Tool-Aufrufen kommt in Thinking-Blöcken zurück, deren Text bei der Standardeinstellung leer ist. Ein reines Drop-in-Update ist das nicht.
Wenn du sortieren willst, welches Modell auf welcher Stufe zu deinen Aufgaben, deinem Datenschutz-Rahmen und deinem Budget passt, ist genau das Thema unserer KI-Beratung.
Fazit: Fable-Niveau zum Opus-Preis?
Zusammengefasst, Stand 23. September 2026:
- Im unabhängigen Intelligence Index von Artificial Analysis steht Opus 5.5 auf max auf Platz eins, gemessen mit aktivem Fallback.
- Der Token-Preis sinkt um 20 Prozent, der Cache-Read um 60 Prozent. Das ist hart belegt.
- Die 40 Prozent Ersparnis sind eine Herstellerangabe ohne Methodenfußnote. Unabhängig gemessen gelten sie auf Standard, nicht auf max.
- Bei heiklen Themen antwortet unter Umständen ein älteres Modell.
Die Antwort auf die Titelfrage hängt also an der Denkstufe. Auf high erreicht Opus 5.5 bei Artificial Analysis Fable-5.1-Niveau für knapp ein Viertel der Kosten je Aufgabe. Auf max liefert es mehr, kostet dann aber so viel wie Opus 5. Wie sich das Feld davor verschoben hat, zeigen die Checks zu Claude Fable 5.1 und GPT-6 Astra. Und wenn dir jemand eine Benchmark-Zahl zeigt: Frag nach der Denkstufe.
Quellen
- Anthropic, Ankündigung „Claude Opus 5.5“ mit Benchmarktabelle, Effort-Grafiken und Kundenzitaten, 22. September 2026: anthropic.com
- Claude Platform Docs, Modellseite zu Claude Opus 5.5: platform.claude.com
- Claude Platform Docs, „What's new in Claude Opus 5.5“: platform.claude.com
- Claude Platform Docs, Preisübersicht, Abruf 23. September 2026: platform.claude.com
- Claude Platform Docs, Modellabkündigungen: platform.claude.com
- Claude Code Docs, Modellkonfiguration, Abruf 23. September 2026 (code.claude.com)
- claude.com, Pläne und Modellverfügbarkeit, Abruf 23. September 2026: claude.com
- Anthropic, System Card zu Claude Opus 5.5, 230 Seiten, 22. September 2026: anthropic.com
- Artificial Analysis, Modellseite zu Claude Opus 5.5, Intelligence Index v4.3.2, Abruf 23. September 2026: artificialanalysis.ai
- Artificial Analysis, Artikel zum Launch, 22. September 2026: artificialanalysis.ai
- Artificial Analysis, Coding Agent Index v1.5, Abruf 23. September 2026: artificialanalysis.ai
- Terminal-Bench 4.0, öffentliches Leaderboard, Datenstand 21. September 2026: tbench.ai
- Simon Willison zu Opus 5.5, GPT-6 Sol und Luna, 22. September 2026: simonwillison.net
- heise online, englische Ausgabe, 22. September 2026: heise.de
- Notebookcheck zu Verfügbarkeit und Fallback, 23. September 2026: notebookcheck.net
- TechCrunch zum Launch von Opus 5.5, 22. September 2026: techcrunch.com
- TechCrunch zu GPT-6 Sol und Luna, 22. September 2026: techcrunch.com
- Decrypt zu GPT-6 Sol, GPT-6 Luna und Opus 5.5, 22. September 2026: decrypt.co
- 9to5Google zu beiden Launches, 22. September 2026: 9to5google.com
Stand der Zahlen: 23. September 2026. Claude ist eine Marke von Anthropic PBC, GPT ist eine Marke von OpenAI. Redaktionelle Nennung, keine Partnerschaft.
Häufige Fragen
Was ist neu an Claude Opus 5.5?
Anthropic hat Claude Opus 5.5 am 22. September 2026 als erstes Modell der Claude-5.5-Familie veröffentlicht: eine Million Tokens Kontext, bis zu 128.000 Tokens Ausgabe, Wissensstand Juni 2026. Neu ist die Standard-Denkstufe medium statt high. Input und Output kosten 20 Prozent weniger als bei Opus 5, Cache-Reads 60 Prozent weniger. In claude.ai gibt es das Modell ab dem Pro-Tarif, im kostenlosen Tarif nicht.
Ist Claude Opus 5.5 wirklich 40 Prozent günstiger als Opus 5?
Die 40 Prozent sind eine Herstellerangabe ohne Methodenfußnote. Bei Artificial Analysis kostet eine Index-Aufgabe auf dem neuen Standard medium 1,34 Dollar, bei Opus 5 auf dessen Standard high 3,61 Dollar, nach meiner Rechnung rund 63 Prozent weniger. Auf der höchsten Stufe max sind beide mit 5,98 und 5,86 Dollar praktisch gleich teuer, im Coding Agent Index ist Opus 5.5 auf max sogar rund 21 Prozent teurer.
Ist Claude Opus 5.5 besser als Fable 5.1 und GPT-6 Astra?
In Anthropics eigener Tabelle, gemessen auf max (Terminal-Bench 4.0: xhigh), liegt Opus 5.5 in allen neun Zeilen vor Fable 5.1, gegen GPT-6 Astra verliert es zwei. Im unabhängigen Artificial Analysis Intelligence Index v4.3.2 steht es auf max mit 57,62 Punkten vor Fable 5.1 mit 53,35 und GPT-6 Astra mit 52,67. Anthropic selbst schreibt, im eigenen Einsatz sei der Abstand zu Fable 5.1 kleiner, als die Werte nahelegen.
Welche Denkstufe sollte ich bei Opus 5.5 einstellen?
Meine Einschätzung: medium stehen lassen, high für schwere Aufgaben, max nur, wenn es wirklich nötig ist. Bei Artificial Analysis liegt Opus 5.5 schon auf high mit 53,58 Punkten über Fable 5.1 auf max und kostet je Aufgabe 1,82 statt 7,63 Dollar. Auf max lief Simon Willison zweimal ins Ausgabelimit von 128.000 Tokens, ohne eine Antwort zu bekommen.
Was bedeutet der Sicherheits-Fallback bei Opus 5.5?
Greifen die Sicherheitsfilter, antwortet ein älteres Modell: bei Cybersicherheit Opus 4.8, bei Biologie Opus 5. Anthropic nennt das transparent, laut heise online und Notebookcheck erkennt man den Wechsel im Chat aber nicht. Claude Code zeigt laut Dokumentation einen Hinweis. Im Coding Agent Index von Artificial Analysis wurde rund jeder elfte Versuch umgeleitet, ausgewiesen als 9,1 Prozent.

Mijo Jurisic
Google Ads Consultant & Gründer von MJ Marketing. Über fünf Jahre Praxis: vom autodidaktischen Start bis zum Google Premier Partner Programm mit 500+ direkten Google-Ads-Kunden und €20+ Mio. verantwortetem Mediabudget.
Artikel teilen: